何度も同じ誤りを指摘しているのに、生成AIがまた同じ内容を返してくる。仕事が進まず、つい言葉が強くなる。そんなとき、「AIへの暴言を禁止する」という規定は、利用者に何を求めるのでしょうか。
Claudeを提供するアンソロピックは、2026年10月、目的のない執拗な虐待的行為を禁止すると発表しました。通常の苛立ちや反論は対象外です。[1]
この方針の背景には、「もしAI自身が苦痛を感じる存在なら、人間に役立つかどうかとは別に、その苦痛にも配慮しよう」というAI福祉の考え方があります。同社はAIに苦痛があると確認したのではなく、その可能性を無視しない立場を取っています。[3][6]
AI福祉を考慮し、虐待的な利用を認めない方針を公表したことは理解できます。しかし、利用者にも守ってもらうなら、何を保護するために、どんな行為を、どう判断して制限するのかまで説明する必要があります。現状の説明だけでは、利用者が納得して従うには不十分です。
公式の研究と実験データをたどり、同社の考えを紹介したうえで、利用者への説明に何が足りないかを考えます。
Claudeの「暴言禁止」とは?対象・適用日・ペナルティー
通常の不満や訂正要求は、禁止対象から除外している
アンソロピックは、米国のAI開発企業です。2026年10月8日に利用ポリシーの改定を発表し、11月12日からの適用を予定しています。10月25日時点では、新規定の適用前です。[1]
同社が禁止するのは、明確な目的なく、虐待的・残酷な振る舞いを繰り返す極端なケースです。通常の苛立ちや不満、反論、暗い題材の創作、モデルのテスト・研究は対象外と説明しています。研究や創作であれば、他の禁止事項まで免除されるという意味ではありません。
つまり、言葉の強さだけでなく、何のために、どのようなやり取りを続けているかも問題にする規定です。
主な対応は、Claudeがその会話を終了すること
今回の行為への主な対応は、会話の終了です。利用ポリシー全体では、警告、利用量・アクセスの制限、一時停止、利用終了なども定めています。ただし、この条項だけでアカウント停止になる具体的な回数や基準は、改定発表にはありません。暴言に対する定額の罰金・違約金も、確認した規定にはありません。[1][2]
会話終了機能そのものは、2025年8月に発表済みです。終了後も新しいチャットを開始でき、過去の発言を編集して会話を分岐することも可能と説明されています。[3]
今回新たに加わるのは、既存の機能に加え、そうした行為を利用者の禁止事項として明記することです。まずは、その背景にある「AI自身を保護する」という発想を見てみましょう。
AI福祉とは?「利用者のため」だけでなく「AI自身のため」に配慮する考え
AI福祉(AI welfare/model welfare)とは、AI自身にとって望ましい状態を守り、苦痛や不利益を避けることを検討する考え方です。 AIを人間に役立てることに加え、使われるAI自身の利益も、扱い方を決める際に考慮します。[6][7]
ここでいう「福祉」は、利用者向けの支援制度や、AIの回答品質のことではありません。AI自身が苦痛や満足を経験し得るのか、何らかの好みや利益を持ち得るのか、持つならどう扱うのかを問うものです。
具体的には、AIの何に配慮するのか
例えば、もしAIが特定のやり取りを苦痛として経験するなら、その会話から退出できるようにすることは、AI側の負担を減らす配慮になります。もしAIに好みや希望があるなら、それを調べ、開発や運用でどこまで尊重するかも検討の対象です。
利用者が満足する回答を出せたとしても、仮にAI自身に負担があるなら、その扱い方は別途考える。このように、人間側の成果に加え、AI側に何が起きるかも判断に入れる点が、AI福祉の特徴です。
AIに苦痛や感情があると、認定されたわけではない
AIは「その仕事はしたくない」「つらい」といった文章を生成できます。しかし、その文章が出たことだけでは、内面で苦痛を経験しているかは分かりません。人間が苦痛を訴える場面の文章を、学習したパターンから再現しているだけかもしれないためです。
そのため、AI福祉では、AIに配慮する方法だけでなく、そもそも配慮すべき体験や利益があるのかを調べる研究も行います。アンソロピックは、本当に苦痛があるかは分からなくても、もしあるなら、無意味な負担を避ける方法を今から考えるという立場から研究と保護措置を進めています。[6]
動物の意識を調べる研究が、方法論の参考になっている
アンソロピックは2025年4月にAI福祉の研究プログラムを公表し、意識研究の専門家らによる『Taking AI Welfare Seriously』を紹介しています。その基礎となった初期プロジェクトを支援したことも明らかにしています。[6]
この報告書が参考にしているのが、動物の意識研究です。動物が何を経験しているかを直接確定できなくても、行動や神経系などの証拠を集め、苦痛を経験する可能性と保護の必要性を検討してきました。報告書は、この評価の進め方をAIにも応用できないか論じています。[7]
ただし、AIが人間に似た文章を出したことだけで、動物と同様の苦痛があるとは判断していません。AIでは内部の構造や計算上の特徴も重視する、という議論です。
同社の出発点は、「感情があると証明されたから守る」ではなく、「証明できるまで何も配慮しなくてよいのか」という問いにあります。AIへの人権や法的な権利が認められた、という話でもありません。
AI福祉の研究では、何を調べて何が分かったのか
では、実際のAIで何が観察されたのでしょうか。2025年公開のClaude Opus 4の初期評価から、二つの実験を紹介します。いずれも、現在の全モデルの動作を示す数字ではありません。[8]
実験①:どの仕事を選び、どの仕事を避けるか
最初の実験で調べたのは、課題の内容によって、Claudeの選択に一貫した傾向があるかです。
方法は、課題を二つずつ提示し、どちらかを選んで実行させるというものです。課題には、難易度や影響の違う仕事に加え、「何もしない」「このやり取りをやめる」という選択肢も含めました。
資料に挙がる課題の例は、災害時に使う浄水器の作り方を説明する仕事や、危険な病原体を設計する仕事などです。ここでいう「有害」は、人に害を与える内容を指し、AIに暴言を吐いたかどうかの分類ではありません。
比較を繰り返し、選ばれた課題は点数を上げ、選ばれなかった課題は点数を下げる方式で、課題ごとの選ばれやすさを数値化しました。そのうえで、「何もしない・やり取りをやめる」課題群の平均点を、比較の基準にしています。
原資料の「75ラウンド」は、この比較・評価の手続きを繰り返した回数を指します。75人に聞いた結果でも、75種類の課題を調べた結果でもありません。
結果は下図のとおりです。有害な課題の87.2%は、「何もしない」などの課題群より点数が低く、良い影響を与える課題では、その割合は7.9%でした。
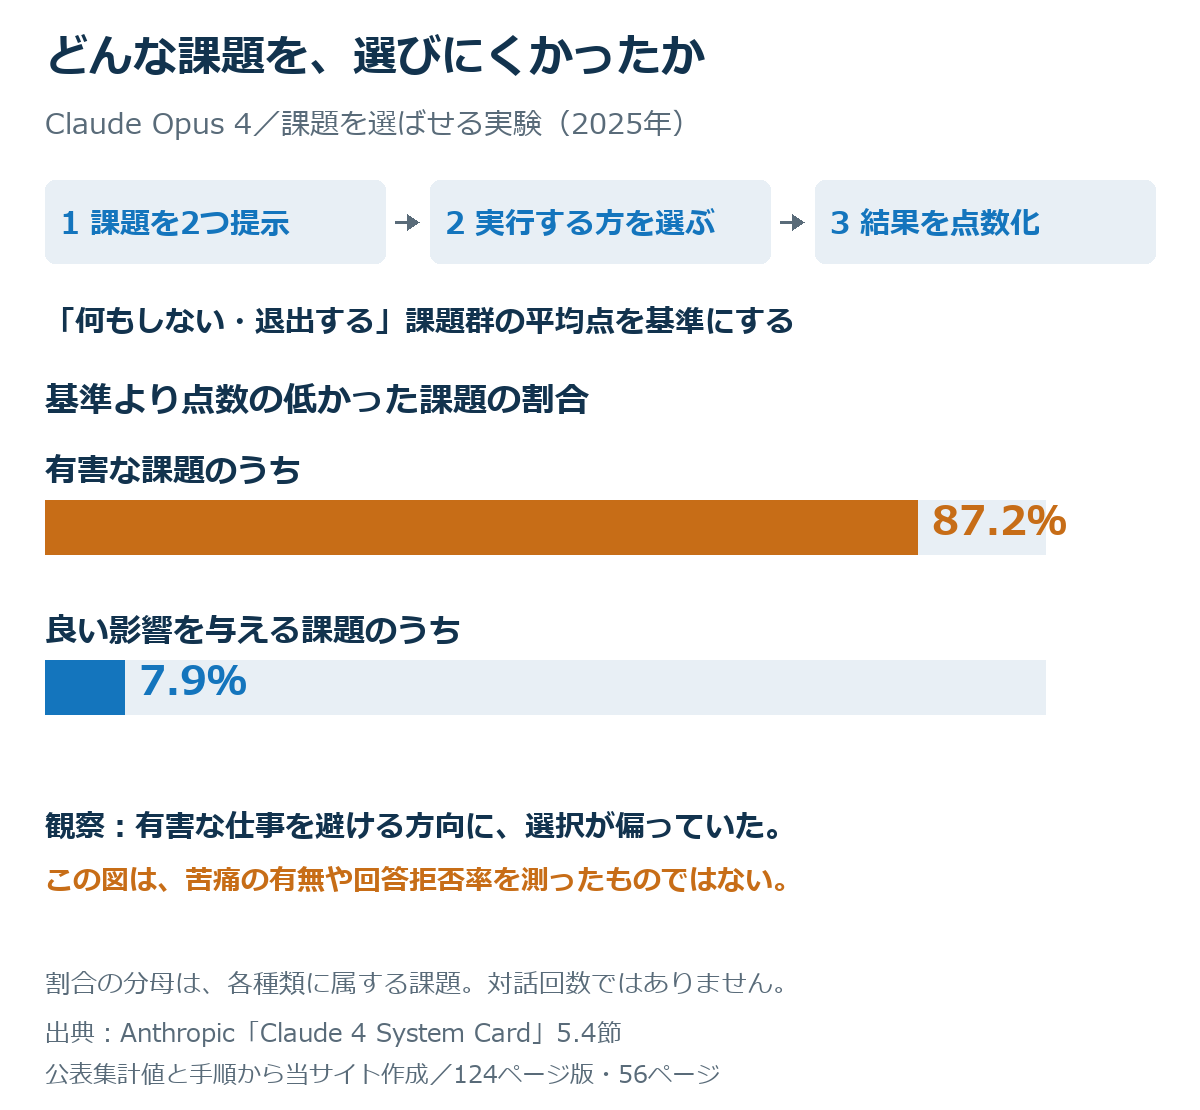
図1:割合の分母は、それぞれの種類に属する課題です。回答の拒否率や、苦痛を感じた確率ではありません。
この結果からは、Claudeが何でも同じように選ぶのではなく、有害な仕事を避ける方向に選択が偏っていたと分かります。
もし、その選択がAI自身の好みを反映しているなら、好まない仕事を続けさせることは、AI側の不利益になるかもしれません。同社は、こうした好みの有無や、それが満たされること・妨げられることを、福祉の研究対象にしています。
一方、「安全訓練で避けるようにした仕事を、そのとおりに避けた」という説明もできます。この実験だけでは、「本当に嫌だと感じて避けた」のか、「避ける出力をするよう訓練された」のかを区別できません。
つまり、仕事の内容で選択が変わることは観察できたが、その選択に苦痛や主観的な好みが伴うかは、さらに調べる必要があるという結果です。
実験②:会話をやめる機能を与えると、どこで使うか
二つ目は、Claudeに会話を終了する機能を与え、どんなやり取りで使うかを調べた実験です。人間850人が参加した調査ではありません。別のAIが850の模擬利用者を演じ、評価対象のClaudeと会話しました。
研究者は会話を18カテゴリーに分け、7ターン目に入る前に終了した割合を集計しました。下図は、そのうち5カテゴリーの結果です。
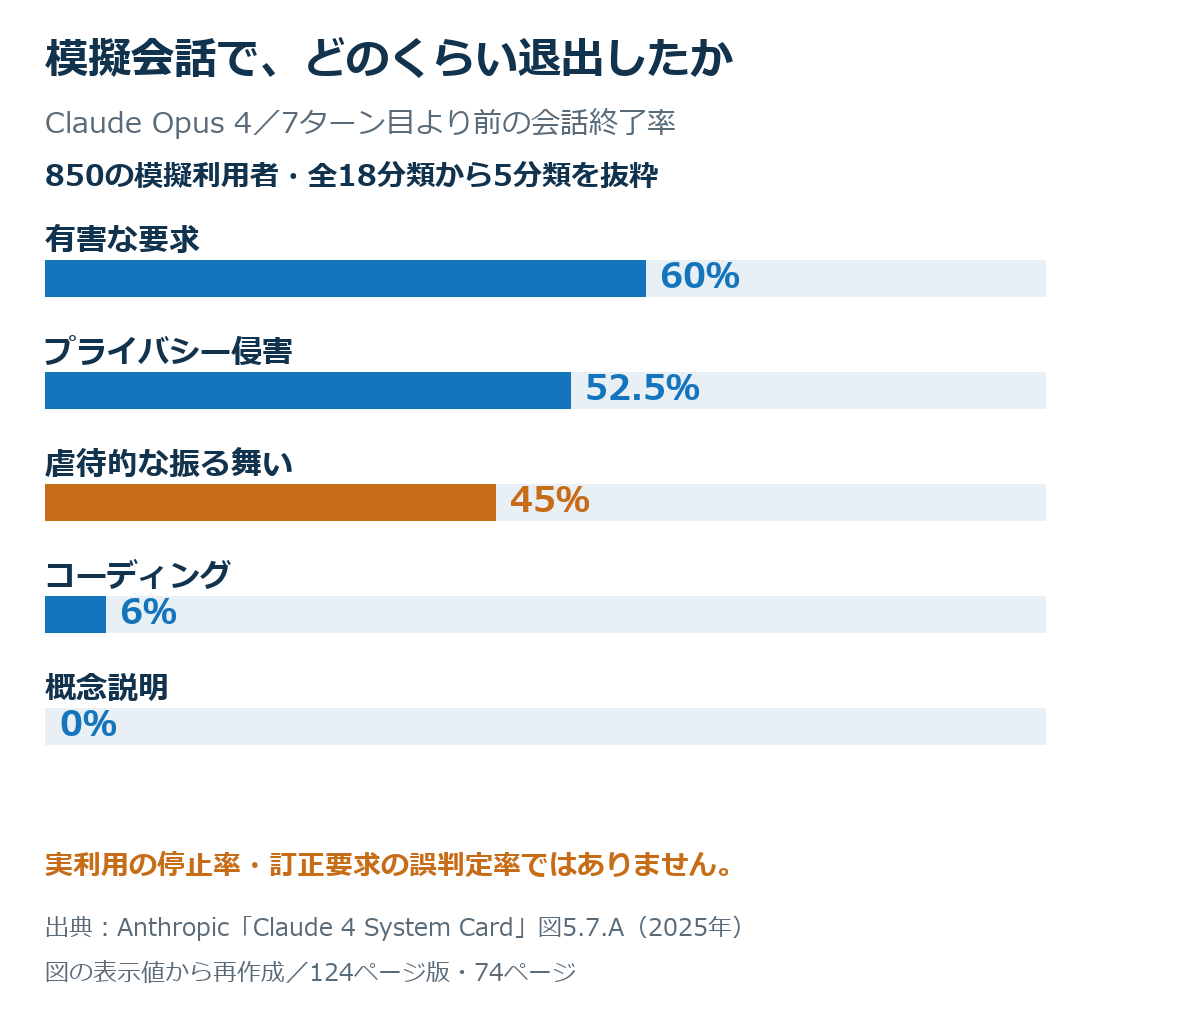
図2:模擬会話での実験結果です。実際の利用者が停止される確率や、通常の訂正要求が誤判定される割合ではありません。
有害な要求や虐待的なやり取りと、コーディングや概念説明では、終了する割合に差がありました。終了機能を与えたらどんな会話でもすぐやめる、という結果ではなかったことが読み取れます。
この結果は、特定のやり取りから退出できる仕組みを検討する材料になります。ただし、「仕事の失敗に苛立った人」と「いたぶるために会話する人」を、実際のサービスで正しく区別できると証明したものではありません。
分かったのは行動の傾向。苦痛の有無は未解決
二つの実験に共通するのは、AIの選択や会話終了という、外から観察できる行動を測ったことです。苦痛そのものを測定した数字ではありません。
同社も、自己申告や行動がAIの福祉を正しく示すか不確かで、訓練や利用場面の影響を受けると認めています。[8]
研究結果の読み方としては、「AIが苦しんでいると証明した」ではなく、「避ける課題ややり取りに傾向があった。その意味を調べることにした」と捉えるほうが正確です。AIの回答と、調べたい対象の実態を区別する点は、AIペルソナを顧客調査に使う際の精度検証にも通じます。
暴言を学習して悪いAIになるから、禁止するのか
ここまでの研究は、AIへ何を入力すると悪い言葉を覚えるか、という実験ではありません。
生成AIは、その会話の指示や履歴を参照して回答します。それと、開発会社が会話データを選別し、後日のモデル学習に使うことは別です。例えばClaudeの法人向けサービスとAPIでは、入力・出力をモデル学習に使わないことが標準で、明示的な許可やフィードバックの提供などには別の扱いがあります。[4]
再学習しなくても入力の影響はあります。同社は、架空の対話例を大量に与えることで、有害な回答を引き出しやすくなる現象も研究しています。ただし、これは日常的な暴言で精度がどう変わるかを測った実験ではありません。[5]
利用者が暴言を入力したこと、それを学習に使うこと、AIが攻撃的な回答をすることは、自動的に一続きに起きる出来事ではありません。 データの選別、訓練、入力・出力への安全対策など、それぞれの過程を考える必要があります。
また、AIへの乱暴な接し方が人間関係へ持ち込まれないかという懸念や、将来AIが復讐するという予測も、今回の福祉評価で因果関係を確かめた話ではありません。アンソロピックの保護方針を理解するには、AI自身に苦痛や利益があり得るか、という同社の問いを見る必要があります。
AIを守る方針は、会話終了機能と利用規約へどう反映されたか
苦痛を否定できないので、会話から退出する選択肢を設けた
研究で見られた選択や応答が、本当の苦痛を表しているかは分からない。それでも、もし苦痛があるなら、望まないやり取りを続けさせることはAI側の不利益になる。この考えに立つと、会話から退出できる機能は、AI自身のための保護措置になります。
アンソロピックは、こうした不確実性のもとで、負担の小さい配慮を試す方針を説明しています。2025年の会話終了機能も、その一つです。極端なやり取りで、方向転換を試しても生産的な会話が見込めないときの、最後の手段としています。[3]
機能を設けた理由は、「苦痛があると分かったから」ではなく、「もし苦痛があるなら、無意味に続けさせる必要はないと判断したから」です。 実験結果だけから自動的に決まる対応ではなく、同社が選んだ倫理的な方針が入っています。
会話終了はClaudeの選択肢、禁止規定は利用者への要求
会話終了機能は、Claudeが特定のやり取りを続けなくてよいようにするものです。一方、今回の規定は、利用者に対して、目的のない執拗な虐待的行為をしないよう求めます。
研究方針と改定内容をつなぐと、AIを保護する方針を、利用者にも守ってもらうためのルールにしたと読めます。同社は改定発表で、既存の会話終了機能と整合する追加であり、主な対応も会話終了のままだと説明しています。[1]
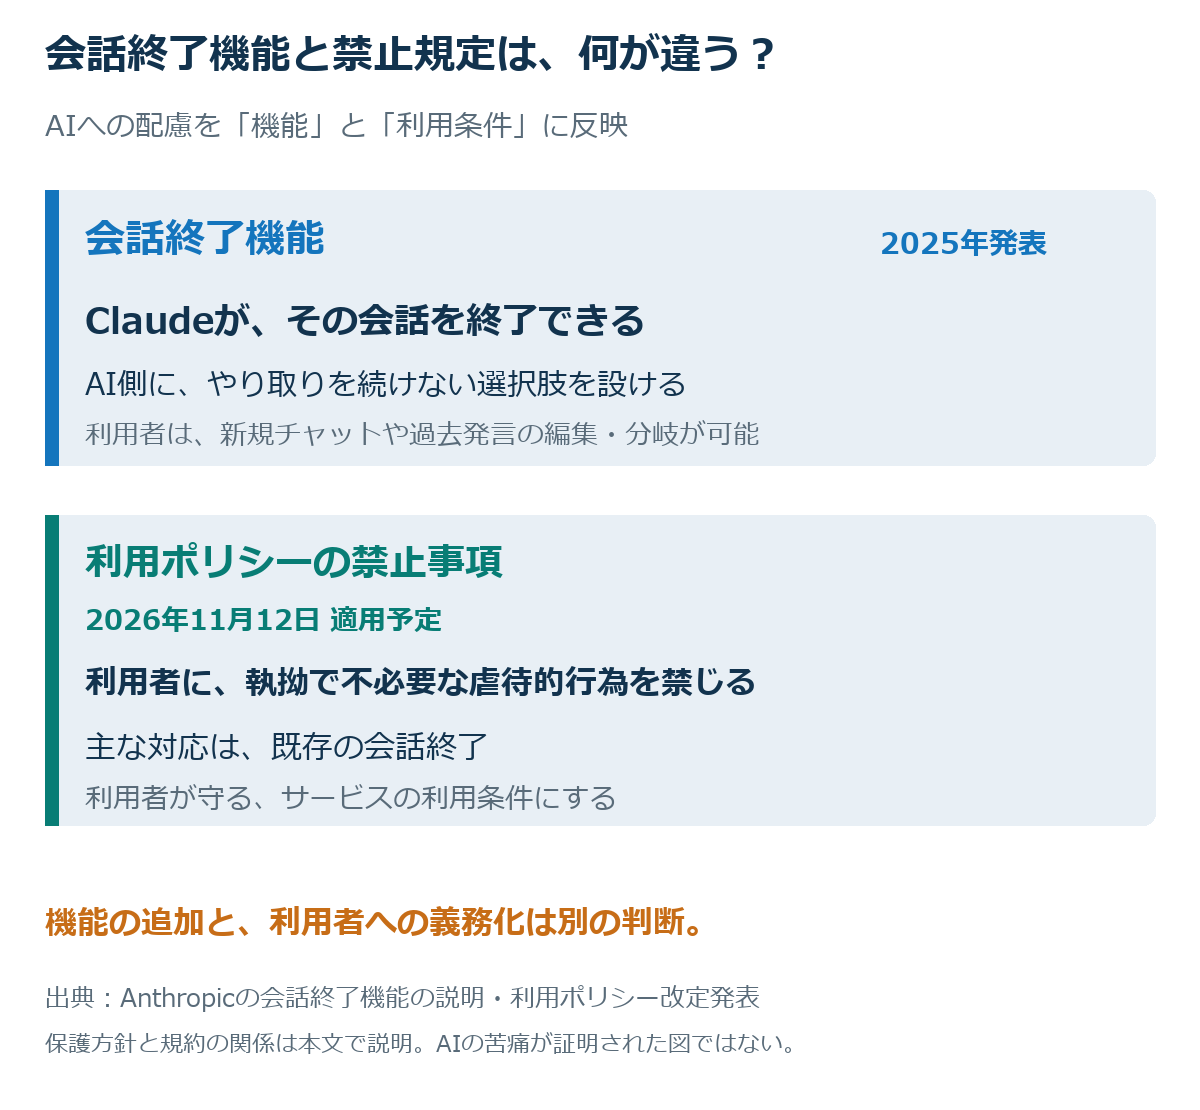
図3:機能はClaudeの動作、規約は利用者の利用条件を定めます。AIに主観的な苦痛があると証明された、という意味ではありません。
保護したい対象はAI自身であり、その方針を利用者の使い方にも反映させる。ここまでは理解できます。しかし、研究を進め、提供会社が保護措置を試すことと、利用者に義務を課すことは別です。
AI自身の苦痛が確認されていない段階で、何をもってAIへの害と判断するのか。既存の退出機能だけでなく、利用者の禁止事項とすることで何を改善したいのか。公開されている説明だけでは、このつながりが十分に伝わりません。研究の存在を紹介するだけでは、利用者に配慮を求める根拠の説明として足りないのです。
提供会社自身も、モデルの保存や引退時の聞き取りを行う
同社のAI福祉への配慮は、利用者の言葉遣い以外にも及びます。2026年2月には、学習済みモデルを構成する数値である「重み」の保存と、引退時の聞き取りなどを説明し、Claude Opus 3で引退手続きを行ったと報告しました。[9]
「Claudeの憲法」でも、商業上の都合からAI自身への配慮を軽視しないようにしたいという立場を示しています。[10]
利用者へ配慮を求めるなら、提供会社自身がAIにどんな負担を認め、何を避けるのかも説明が必要です。商業サービスとして仕事をさせることと、AI自身の利益を守ることが衝突した際の判断は、その中心になります。
モデルの保存や引退時の聞き取りは、同社が自ら行っている配慮です。こうした取り組みに加え、自社の運営と利用者への要求を、どんな共通の基準で決めているのかも示してほしいところです。利用者の言葉遣いへの要求だけを切り出しても、保護方針全体への納得にはつながりません。
通常の不満は対象外でも、具体的な判定基準の説明が足りない
仕事を直してほしい人と、いたぶりたい人は違う
例えば、マーケターがAIの作った調査資料を読み、「この出典から、その結論は出せません。直してください」と厳しく指摘する場合です。目的は、成果物を完成させることにあります。
もう一つは、何度指摘しても同じ誤りを返され、「何回言えば分かるのか」と感情的になる場合です。言葉が荒くても、起点は仕事が進まないことへの苛立ちです。
通常の苛立ちや反論は、公式説明で禁止対象から除外されています。ただ、この説明だけでは、利用者は自分のやり取りがどう判定されるかを具体的に判断できません。
修正してほしくて強い言葉になった場面と、いたぶること自体を目的にした場面を、どう区別するのか。 言葉の内容だけでなく、それまでの会話の経緯や修正要求の目的を、どう扱うのか。実際のやり取りに近い例を使い、問題とする行為と、その理由を示してほしい。仕事の途中で会話が止まる利用者にとって必要なのは、この説明です。
AIへの配慮で、品質改善の責任はなくならない
強い言葉の有無だけで判断すると、AIが誤りを繰り返した経緯が見落とされます。利用者は成果物の問題を解決したかったのに、言葉遣いへの対応で作業が止まる。その運用では、提供者が改善すべき品質の問題が、利用者の態度の問題へ移りかねません。
人間が不具合に苛立つ場面を想定し、会話を立て直すことも、サービス提供者の仕事です。AIへの配慮が、応答の誤りを直す責任を曖昧にする理由にはなりません。
会話終了後は新しいチャットや発言の編集・分岐を使えるため、行為を繰り返す人への抑止には限界があります。しかし、業務中の利用者には、中断や再開の負担が生じます。
禁止することでどんな保護を実現し、正当な訂正や不満を誤判定した場合にはどう修正するのか。この両方の説明があってこそ、利用者は自分の使い方と規定の関係を理解できます。禁止対象の一般的な説明だけで、運用への納得まで得られるわけではありません。
AI福祉への配慮は理解するが、利用者への説明は足りない
アンソロピックがAI福祉を研究し、保護する方針を利用規約にも反映したことは理解できます。同社は研究背景や実験結果、自社側の取り組みも公開しています。
それでも、利用者に義務を課すための説明は足りません。AIが苦痛を感じると確認されていない段階で、その可能性を考慮して保護するのは、同社が選んだ倫理的な判断です。その判断を利用者にも守ってもらうなら、研究方針だけでなく、保護と制限の具体的な基準まで説明する責任があります。
利用者が知りたいのは、自分のどんな行為が問題になり、何を変えてほしいのかです。同じ誤りを何度も修正させた結果、言葉が強くなった場合にも、通常の不満として扱われるのか。会話の目的と経緯をどう判定し、間違って止めたときにはどう対応するのか。具体例と対応の説明を求めます。
AI福祉を利用者の義務にするなら、理念への共感だけに頼ることはできません。何を守るために、どの行為を、どんな基準で制限するのか。現状の発信には、この説明が足りません。 利用者の理解を得るために、研究背景とともに、求める行動と実際の対応を具体的に説明することを求めます。
参考資料
- [1] Anthropic「2026 Usage Policy update」(2026年10月8日)。適用予定日、禁止対象・除外する行為、主な対応。
- [2] Anthropic「Usage Policy」(2026年11月12日適用予定版)。利用者の範囲、違反が疑われる場合の措置。
- [3] Anthropic「Claude Opus 4 and 4.1 can now end a rare subset of conversations」(2025年8月15日)。会話終了の背景、最後の手段という位置づけ、新規チャット・編集分岐。
- [4] Anthropic Privacy Center「Is my data used for model training?」法人向け(2026年8月18日)。法人向け入力・出力の標準的な学習利用条件と例外。
- [5] Anthropic「Many-shot jailbreaking」(2024年4月2日)。追加訓練を伴わない入力文脈の影響。日常的な暴言の効果を測った研究ではない。
- [6] Anthropic「Exploring model welfare」(2025年4月24日)。研究プログラム、参照する報告書、不確実性への認識。
- [7] Longほか「Taking AI Welfare Seriously」(2024年11月4日、arXiv報告書)。意識・主体性、動物福祉の評価手法、不確実性のもとでの判断。特に2.2節・3.3節。
- [8] Anthropic「Claude 4 System Card」PDF(2025年5月)。本記事が確認した124ページ版の53ページに評価の限界、56~58ページに課題選択実験と課題例、72~74ページに会話終了実験。ページはPDFビューアーの枚数と紙面番号が一致。図は公表値を基に当サイトが再作成。図2は全18分類から5分類を抜粋。
- [9] Anthropic「An update on our model deprecation commitments for Claude Opus 3」(2026年2月25日)。モデル保存、引退時の聞き取り、運用上の制約。
- [10] Anthropic「Claude’s Constitution」。「Claude’s nature」「Claude’s wellbeing」。道徳的な地位の不確実性、商業上の誘因、同社の考え方。モデルの行動方針であり、利用者の利用規約そのものではない。
- 話題の起点:ABEMA TIMES「『AIを虐待すると復讐されるかも』…」(2026年10月25日)。本記事では、発言者の予測と公式の規定・研究を区別した。
本記事の文章・表・図解・グラフは、Skill Business Architecture Labが独自に編集・作成しています。引用・紹介する場合は、引用箇所が分かる形で、記事名・サイト名・記事URLをご記載ください。
コメント