障害を復旧しても、同じ問い合わせや手作業がまた発生する。改善したいのに、目の前の運用と新機能の開発で予定が埋まっている。サービスを運営する会社では、この循環をどう抜けるかが課題になります。
SREは、ソフトウェアの設計・開発の考え方を運用へ持ち込み、必要な信頼性を確保しながら、繰り返す作業や障害を減らしていく取り組みです。日本語では「サイト信頼性エンジニアリング」と呼ばれます。
良い取り組みに見えても、導入は簡単ではありません。改善で余力を生むために、まだ余力のない現場から改善時間を取り出し、それを実行できる人材を確保する必要があるためです。
この記事では、SREの意味、DevOps・インフラ運用との違い、具体的な仕事と指標を説明します。そのうえで、Googleや国内企業の公開事例から、リソースと人材の壁、自社で取り入れる際の判断材料を整理します。技術部門の責任者に加え、運用への投資や人員配置を判断する経営者にも分かるよう、技術用語と業務の関係を具体例で見ていきます。
SREとは?運用をソフトウェアで改善する考え方
SREはSite Reliability Engineeringの略です。システムを動かすために毎回人が対応する方法だけに頼らず、コード、設計、計測、業務の見直しによって、サービスを安定して提供できる状態をつくります。取り組みを担う職種として、Site Reliability Engineerという呼称も使われます。
障害への対応と、繰り返す負担を減らす仕事をつなぐ
例えば、受注サービスの処理が遅くなるたびに、担当者がサーバを追加している会社を考えます。追加して復旧することは、その時点の顧客への影響を抑えるために必要です。ただ、利用者が増えるほど同じ対応が増えるなら、人を増やさなければ運営できない状態が続きます。
SREの観点では、どの条件で処理が遅くなるのかを測り、適切な増設の自動化、処理方法の変更、不要な処理の削減などを検討します。担当者が対応した事実を、次に同じ負担を生まない仕組みへ変える仕事です。
GoogleのSRE書籍は、運用を担当する組織へソフトウェアエンジニアリングの能力を持ち込む発想を説明しています。ここでいうソフトウェアの活用は、すべての作業を大規模な開発で置き換えることではありません。設定を再現できるようにする、小さな手順を自動化する、そもそも不要になった依頼をなくすことも含まれます。
対応する人が優秀だから回る状態から、同じ問題に人の時間を使い続けなくても回る状態へ変える。 この違いで捉えると、SREが単なる新しい職種名ではないことが分かります。
インフラエンジニア・DevOps・CISOとの違い
SREと従来の運用業務には重なりがあります。インフラエンジニアも自動化や設計改善を行うため、「運用担当は手作業、SREだけが開発する」と二分すると実態を誤ります。
| 比較するもの | 主な意味・焦点 | SREとの関係 |
|---|---|---|
| インフラエンジニア・運用担当 | ネットワーク、サーバ、クラウドなどの構築・維持・運用 | 担当領域が重なる。SREではサービスの信頼性目標と継続的な改善を明示して仕事を組む |
| DevOps | 開発と運用などが協働し、変更を速く安全に届ける考え方・実践 | SREは、その考え方を信頼性目標や運用改善として具体化する方法の一つ |
| SRE | サービスの信頼性を測り、運用の負担と変更のリスクを改善する実践 | 職種名だけでなく、目標・時間配分・実行方法を含む |
| CISO | 全社の情報セキュリティを統括する責任者 | 連携するが別の役割。事業部門、委託先、情報管理などをまたぐ全社統括はSREだけでは完結しない |
Googleの実践書も、SREとDevOpsを完全に対立する二つの方式としては説明していません。DevOpsを実践する会社が、信頼性の管理にSREの方法を使うという組み合わせが成立します。
また、信頼性には安全性との接点がありますが、脆弱性の更新、個人情報の扱い、事故時の対外説明まで、SRE担当者に自動的に全部任せられるわけではありません。全社の責任分担は、CISO・CSOの役割と日本企業の設置実態で詳しく整理しています。
SREは具体的に何をする?仕事とメリット
SREは、監視、自動化、障害対応、性能・容量の改善、変更の安全性確保などを組み合わせます。これらの仕事を、サービスの使いやすさと、運営に必要な人の時間の両方へ結びつける点が重要です。
監視・障害対応・変更を、改善につながる情報にする
監視では、サーバが動いているかだけでなく、利用者が操作を完了できるか、遅くなっていないかを見ます。例えば注文ボタンを押しても確定できないなら、サーバの稼働が正常でも顧客にとっては問題です。
Googleの監視に関する章では、待ち時間、処理量、エラー、資源の逼迫を主要な観点に挙げています。ただし、測れる値をすべて担当者への緊急通知にすると、確認すべき通知が増え、本当の問題を見つけにくくなります。情報を集めることと、人を呼び出す条件を決めることは別です。
障害時には影響を抑えて復旧し、その後で、発生条件、検知、連絡、対応手順を振り返ります。人のミスという説明で止まらず、誤操作を防ぐ仕組みや変更を戻す方法を検討すると、次の対応を変えられます。振り返りの結果を誰がいつまでに直すかも、通常の開発計画に載せる仕事です。
新機能のリリースでも同様です。小さく変更し、影響を観測し、問題があれば前の状態へ戻せるようにする。速さと安定性の両方を、毎回の担当者の慎重さだけに依存させない仕組みをつくります。
トイルを減らし、サービスが成長しても手作業を増やし続けない
トイルとは、運用の中で発生する、手作業で反復的、長期的な改善が残りにくい作業などを指します。例えば、同じ条件のアカウント追加を毎回個別に行う、同じ警告を確認して毎回問題なしと判断する、といった作業です。
必要な仕事であっても、サービスの利用量と一緒に手作業が増えると、成長のたびに人員が必要になります。逆に、申請の標準化や利用者自身が操作できる仕組みをつくれば、同じ人員でも扱える範囲を広げられます。
ただし、珍しい例外や高リスクの判断を、すべて無人化する必要はありません。例外対応に必要な確認まで消すと、誤処理の影響が大きくなります。頻度、所要時間、判断の難しさ、誤った場合の影響を分け、標準化できる部分から改善する方が実務的です。
例えば毎週の定例集計なら、入力データの取得と計算を自動化し、結果の妥当性は人が確認する方法もあります。完全な自動化が難しいという理由で改善を止めず、どこまで機械に任せれば負担が減るかを考えます。
この改善は、単に担当者を楽にするだけではありません。手戻り、属人化、対応待ちを減らせば、サービスを変更できる余力が生まれます。運用の効率化で生まれた時間を次の改善へ戻すことで、人を増やす以外の成長方法ができるのです。
SLI・SLO・SLAとエラーバジェットを、事業判断へつなぐ
SREを理解する際につまずきやすいのが、指標の略称です。重要なのは名前を覚えることより、何を測り、どの水準を目指し、未達なら仕事をどう変えるかをつなげることです。
利用者ができてほしいことから指標を決める
SLIはサービスの状態を測る指標、SLOはその目標です。SLAは、サービス提供者と顧客の間で定めるサービス水準の合意です。SLAには適用条件や未達時の取り扱いがあり、社内の改善目標であるSLOとは役割が違います。
説明用に、ECの注文確定処理を考えます。「対象とする正当な注文要求のうち、正常に処理できた割合」をSLIとし、「直近30日で99.9%以上」をSLOにする方法があります。実際の設計では、何を正当な要求とし、どの結果を成功と数えるかも決めます。
正常に完了しても、何十秒も待たされれば顧客は離れるかもしれません。その場合は、一定時間以内に処理できた割合など、応答の速さにも目標が必要です。一方、夜間の社内集計で朝までに完了すればよい業務なら、即時応答を目指すより、締め時刻までに処理が終わることが重要になります。
同じ技術を使うシステムでも、利用者の仕事が違えば必要な信頼性も違います。 全サービスへ同じ稼働率を当てはめる前に、何ができないと業務が困るのかを整理します。
Googleの「Embracing Risk」は、信頼性を極限まで高めるには設備費だけでなく、新機能へ使えた開発時間も必要になると説明しています。高い数値を掲げること自体ではなく、必要な水準と投資の釣り合いを考えるのがSREの出発点です。
エラーバジェットで新機能と信頼性改善の優先順位を変える
エラーバジェットは、目標とする信頼性から計算される、許容する不成功の量です。予算という名前でも、金額ではありません。
先ほどの注文処理で、30日間の対象要求が100万件、成功率の目標が99.9%なら、不成功の上限は1,000件です。すでに700件が不成功なら、残りは300件。この計算は説明例であり、EC事業の標準的な推奨値ではありません。
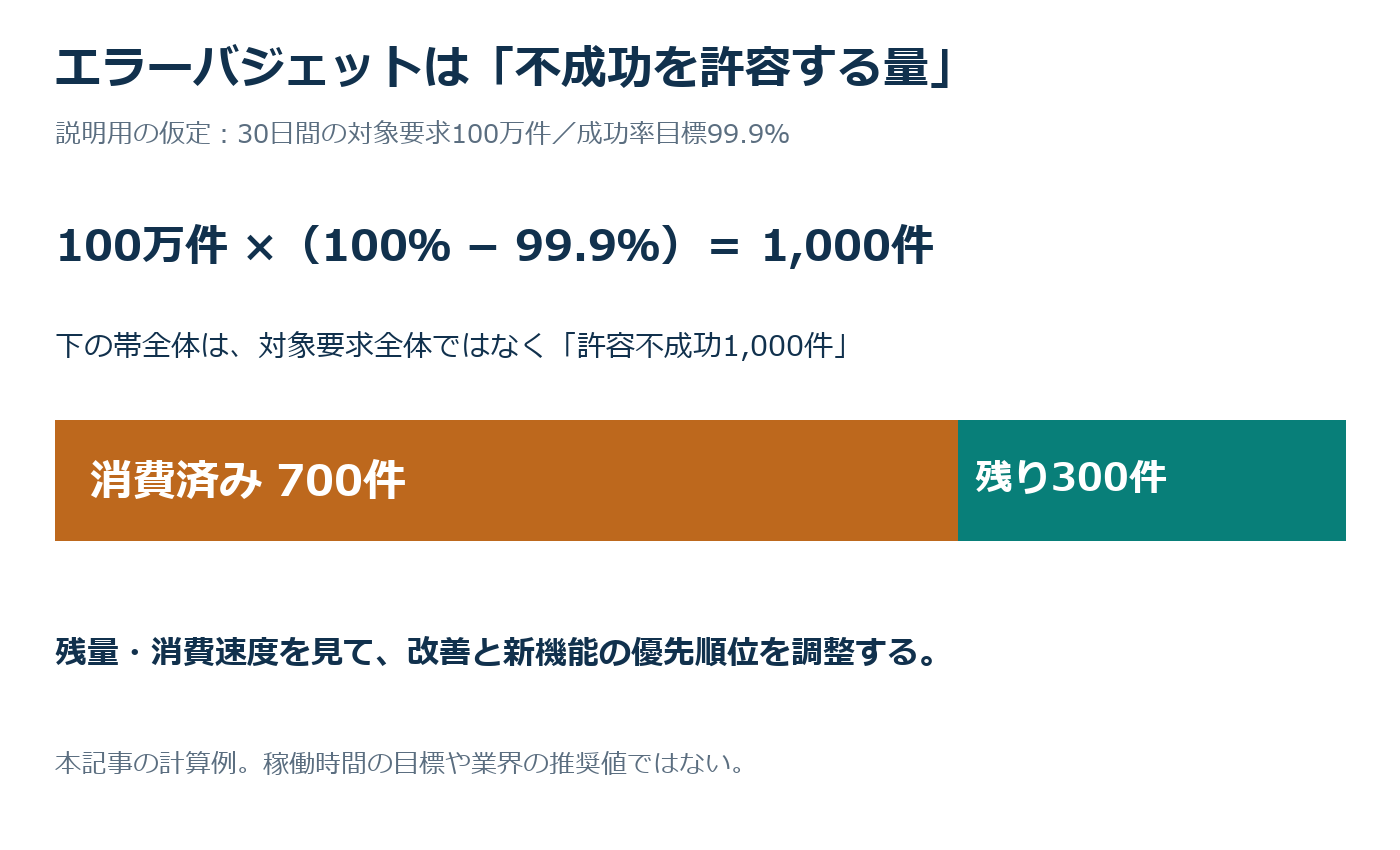
ここで決めたいのは、残量を表示することだけではありません。どの程度の消費速度なら原因調査や改善を優先するのか、新機能のリリース条件をどう変えるのかを、開発側と合意します。
Googleの実践書には、直近4週間でバジェットを超過した場合、緊急性の高い修正やセキュリティ修正を除いて変更を止める方針例があります。これは全企業への一律の規則ではなく、信頼性が悪化したときに改善へ時間を振り向ける合意の例です。
残量があるから何をしてもよい、なくなったら事故対応まで止める、という意味でもありません。事業上の重要な処理であれば、全体の不成功が少なくても個別に対応が必要です。全体の指標と重大な個別事象は分けて扱います。
「売上につながる機能を先に作りたい」という要求と、「今は再発防止へ時間を使いたい」という要求を、測定値と事前の合意から調整できるようになります。SREの指標は、技術部門の成績表にとどまらず、開発資源の配分を変える材料です。
なぜSREの導入が進まないのか:リソースの問題
SREの価値が分かっていても、日常の対応と改善を同時に進めるには移行の負担が発生します。「改善できれば楽になる」と「今その改善に着手できる」の間には隔たりがあります。
改善時間を、まだ改善していない現場から取り出す必要がある
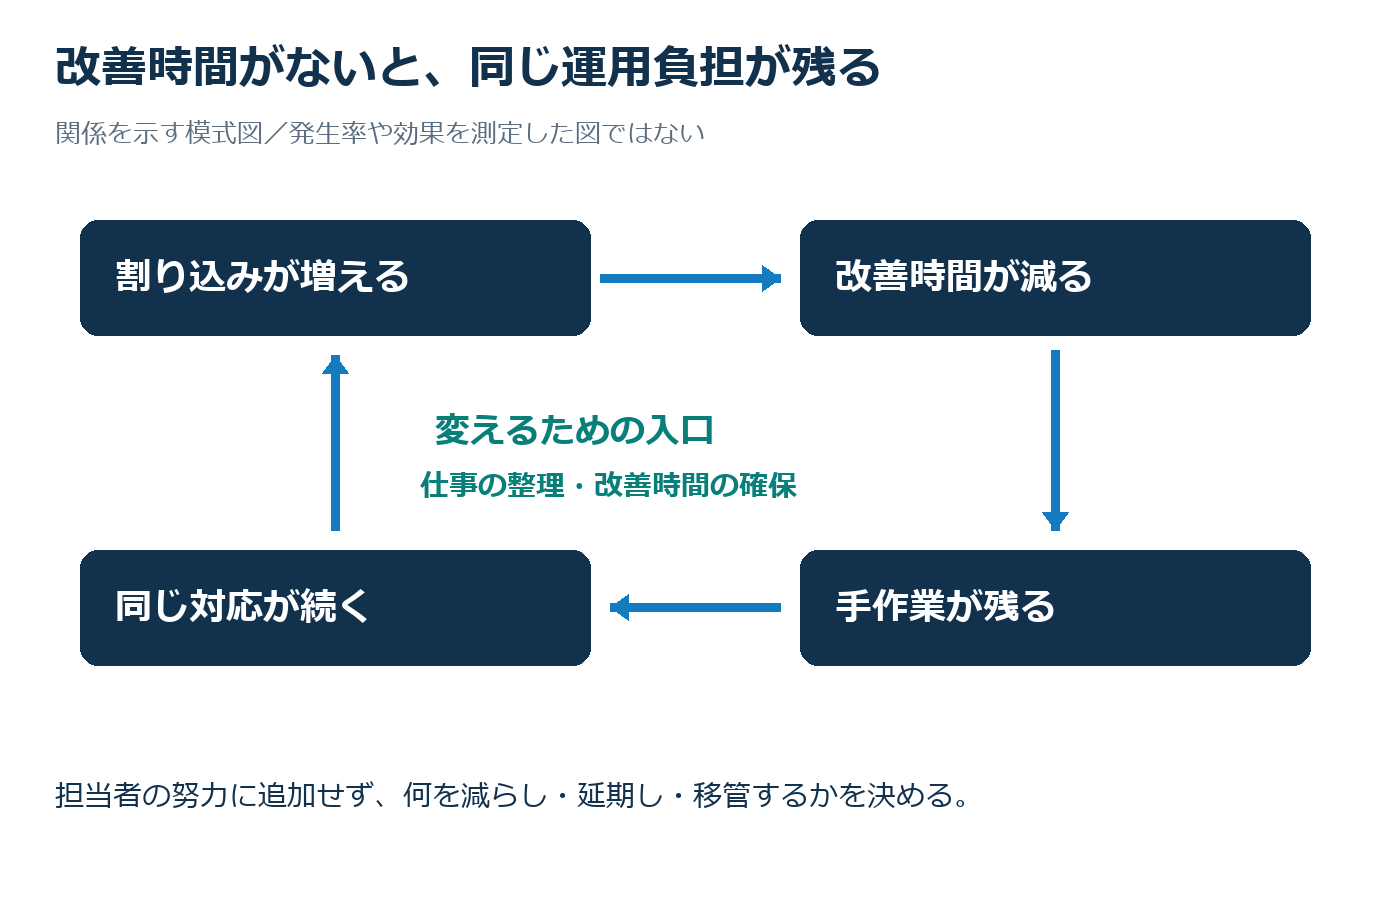
例えば4人の運用チームが、障害対応、問い合わせ、定例作業でほぼ埋まっている場合を考えます。自動化を進めるために一人を開発へ回すと、残りの人が従来の仕事を多く持つことになります。改善効果が出る前に、目先の負担が増えるのです。
開発チームへ手伝ってもらう場合にも、新機能の納期との調整が発生します。改善の成果は将来の負担減ですが、新機能の延期は今期の計画に表れます。現場だけで調整できなければ、担当者が空いた時間や残業で改善する形になりがちです。
Googleは、SREの運用業務を50%以下に抑える方針を示しています。残りを設計や改善などに充てるための考え方であり、全チームが常に達成した実測平均でも、50%の工数削減効果でもありません。
自社で同じ比率にするかは別として、改善時間を予定に入れなければ緊急対応に押し出される問題は参考になります。改善の担当だけを決めるのではなく、何を延期・削減・移管して時間をつくるかまで、通常の人員計画に含める必要があります。
Googleでも過負荷は起きる。2016年の立て直しから学ぶ
Googleの公開事例では、2016年に社内ストレージを担うSREチームの約3分の2が短期間に異動し、作業が滞留しました。チームは仕事を棚卸しし、不要・重複案件の終了、手順の公開、小さな自動化を組み合わせました。集中した整理と実装の2日間で、数か月分の滞留への対応を進めています。
これは、数か月分の障害を2日ですべて技術的に修理したという話ではありません。すでに不要な依頼を閉じ、利用者自身で対応できる仕事を切り出し、実施する対象を減らしたことが含まれます。
参考になるのは、自動化する前に「本当に今も必要な仕事か」を見直した点です。すべてを従来どおり続けたまま改善を追加するより、終了できる仕事を先に探す方が、着手に必要な余力をつくれる場合があります。
小さな自動化と、業務を廃止する改善では投資条件が違う
一つの定例作業を自動化するなら、担当者が小さく試せることがあります。一方、利用部門が多い申請業務をなくすには、代替手段、利用者への説明、データ移行、例外対応が必要です。後者は運用チーム内だけの効率化では完結しません。
まずは、作業を続けながら改善する期間に必要な人員・時間を見積もります。担当者が改善へ回ることで、問い合わせの返答や新機能の提供がどの程度遅れるのか。その影響と、改善後に減る作業を並べると、経営や事業責任者も判断しやすくなります。
一時的に外部へ運用を委託し、社内の詳しい人を改善へ回す方法も考えられます。ただし、委託するだけでシステムを変更できる知識や権限が手に入るわけではありません。仕事の受け渡しと、改善を担う人材は一緒に設計する必要があります。
SREに必要な人材:技術と事業をつなぐ力
SREに必要なのは、決まった操作を実行できることだけではありません。安全に変更を実装する力と、何を改善すれば事業に役立つかを選ぶ力が必要です。両方を一人で完璧に担う採用条件にするより、どこをチームで補うかを整理する方が現実的です。
自動化・設計・復旧を安全に実装する技能
技術面では、ソフトウェア開発、OSやネットワーク、クラウド、データベース、監視、障害調査などの知識を、担当サービスに応じて組み合わせます。すべてに同じ深さの専門性が必要という意味ではありません。
例えば、定例のデータ削除を自動化するなら、正常に動くプログラムを書くだけでは足りません。誤って必要なデータを消さない条件、権限、実行記録、途中で失敗した場合の扱いを設計します。運用で一度だけ人が慎重に行っていた操作を、繰り返し安全に実行できる形へ変える技能です。
また、監視の通知を減らすなら、通知を止めた後も重要な異常を検知できるかを確かめます。件数だけ減らしても、見逃しや復旧の遅れが増えれば改善とは言えません。作業の削減とサービスの状態を一緒に確認できることが重要です。
このため、運用経験者がプログラミングを学ぶ経路も、開発経験者が本番運用を学ぶ経路も考えられます。本人の既存の強みと、対象システムで不足する技能から育成計画を組みます。
GoogleのMoiraは、利用者と代替業務を理解する改善だった
Googleの実践書が紹介するMoiraは、社内ストレージのホームディレクトリを段階的に廃止した取り組みです。CDSチームは利用実態を調べ、共有、文書編集、設定保存などの用途を分け、それぞれの代替先を整えました。平均3人のメンバーによる複数年の取り組みで、対象は約6万5,000から執筆時点の約50へ減少しています。
この件数は、工数の削減率や全社の投資利益率ではありません。注目したいのは、単に古い機器を新しくしたのではなく、「誰が、何に使い、どうすれば代わりの方法へ移れるか」を調べて変更したことです。
手作業を減らすには、プログラムで操作を置き換える以外に、仕事の前提を変える方法もあります。その場合、技術担当者には、利用部門の業務を理解し、不便になる点や例外への対応を含めて移行を進める力が必要になります。
ビジネスアーキテクトに重なる能力を、チームで担う
IPAのデジタルスキル標準におけるビジネスアーキテクトは、変革の目的を定め、関係者を調整し、目的の実現まで推進する役割を扱います。SREそのものと同じ職種ではありませんが、改善対象を選び、関係者の合意へつなぐ部分には重なりがあります。
例えば技術担当者が「申請対応を自動化したい」と考えても、申請の承認権限が曖昧なら、現行手順をそのままコードにするのは難しいでしょう。利用部門、情報システム、管理部門で、承認条件や例外を先に整理する仕事が発生します。
ここで必要なのは、技術者全員を事業企画の専門家にすることではありません。SREが実態と選択肢を整理し、事業責任者が必要な水準と優先順位を決め、開発責任者が実装の計画へ反映する分担も成立します。
| 担う役割 | 改善で受け持つことの例 |
|---|---|
| SRE・運用改善の担当 | 現状の計測、問題の技術的な整理、改善案の実装と検証 |
| 開発責任者 | 新機能と改善の計画、担当者の確保、変更方法の調整 |
| 事業責任者 | 顧客や業務への影響、必要な水準、優先する改善の合意 |
| 経営・予算責任者 | 部門内で決められない投資や資源配分、残るリスクの判断 |
SREを採用したのに改善が動かない場合、本人の技術力だけが問題とは限りません。改善したい対象を変更する権限がない、利用部門の合意を取る人がいない、時間を確保する判断がされない、といった不足も確認できます。
国内企業の事例:組織をどう分担しているか
国内企業の公開記事を見ると、SREという名称を使っていても、開発と運用の分け方は一つではありません。自社へ取り入れる際には、組織名より、どこで専門性を共有し、誰が実装と運用に責任を持つかが参考になります。
メルカリの2020年の事例:各開発チームを専門チームが支援する構想
メルカリが2020年7月に公開した採用記事では、SREチームが運用管理に加え、コードの変更による性能改善などを担当していました。また、サービス基盤を各開発チームが運用し、SREが専門性を提供する体制をつくる方針も説明されています。
これは当時の構想を含む紹介で、現在の全社体制や移行後の成果を示す資料ではありません。参考になるのは、専門チームへすべてを集める以外に、現場の開発チームが運用を担いながら支援を受ける設計もある点です。
自社でこの形を考えるなら、支援を求める窓口、共通の監視や変更手順、難しい問題の相談先を用意する必要があります。「各チームで運用してほしい」という指示だけでは、経験の差がそのまま運用の差になります。
LINEヤフーの2026年の事例:責務を分け、対話を増やす
LINEヤフーの2026年5月の技術ブログでは、LINE Platformにおける開発・運用分離を紹介しています。開発側が手順書や変更内容を整え、運用側がレビューする一方、権限変更や追加の確認による戸惑いも説明されています。
ここから分かるのは、分業を決めると、引き継ぎやレビューの仕事も発生することです。役割を分けたことだけで負担がなくなるわけではなく、依頼の方法、確認する観点、事故時の連絡をそろえる必要があります。
DevOpsは協働を重視しますが、それは全員が同じ権限を持ち、同じ操作をすることと同義ではありません。自社のサービスや統制上の要件に合わせて責務を分けても、情報を共有し、改善を一緒に進めることはできます。
二つの事例を、どちらが正しいかを決める比較にする必要はありません。分散させるなら専門性を支える仕組み、分けるなら連携を支える仕組みが要る。 この観点で自社の組織を検討できます。
自社でSREを始めるには?対象・時間・担当・判断を決める
最初から専門チームを新設する方法だけでなく、既存チームが一つの重要サービスで改善を始める方法もあります。Googleのチーム運営に関する章も、専任SREがいなくてもSLOを使った実践は始められると説明しています。
一つの重要サービスで、改善の対象を具体化する
最初に選びたいのは、会社にとって重要で、繰り返す問題や作業を把握できる対象です。「クラウド全体を改善する」では広すぎますが、「注文確定の失敗と、そのたびに発生する再処理を減らす」なら、利用者への影響と担当業務を対応させられます。
現状では何が起き、誰が何時間使っているかを短い期間でも記録します。通常の作業、障害対応、問い合わせ、改善のための開発を分けると、どこへ時間が流れているかが見えます。記録そのものが重くならないよう、既存のチケットや作業記録を活用します。
次に、利用者に必要な状態と、それを測る指標を決めます。目標が決まれば、優先する改善、延期できる改善、監視する結果がつながります。実装担当と利用部門が違うなら、両方が目標を理解できる説明にします。
改善期間には、対応量が一時的に減る可能性も含めて計画します。例えば週の一部を改善に確保するなら、問い合わせの優先順位や応答方法を調整し、その時間が毎回消えないようにします。割合をGoogleと同じにすることより、決めた改善を実際に進められることが大切です。
改善投資は、削減時間・保守費・事業影響を分けて見る
自動化の費用対効果は、削減時間だけでも一度整理できます。例えば月20時間の作業を月5時間に減らせる改善に、60時間の開発が必要だとします。保守を考えなければ、月15時間の削減で4か月が時間回収の目安です。
ところが改善後も月3時間の保守が増えるなら、実質の削減は月12時間で、回収は5か月になります。これは説明用の単純計算で、一般的な相場や成果実績ではありません。
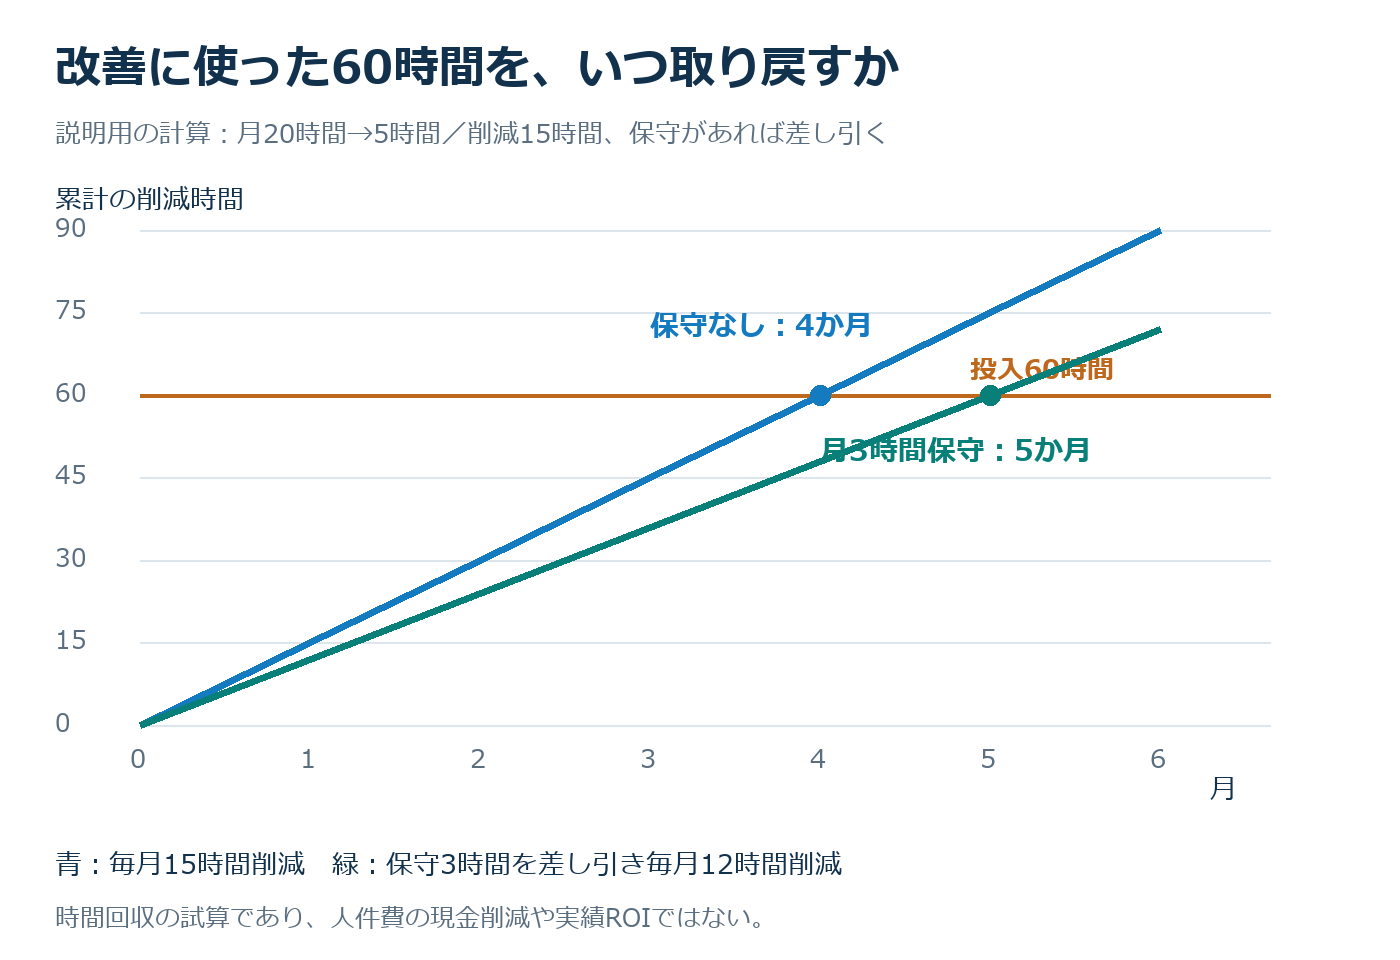
同じ計算を使う場合も、削減した時間が直ちに現金の人件費削減になるとは限りません。残業が減る、別の改善へ時間を回せる、利用増に対応できるなど、得られるものを区別して説明します。
反対に、月数時間しか減らなくても、誤操作で重要データを失う危険を抑えるなら、時間以外の価値があります。顧客の待ち時間、注文失敗、復旧までの時間、担当者への依存など、改善の目的に対応する成果を選びます。
| 確認したいこと | 投資判断での意味 |
|---|---|
| 発生頻度と作業時間 | 今どの程度の負担があり、改善余地がどこにあるか |
| 開発・導入・移行の時間 | 効果が出る前に、何をどれだけ投じるか |
| 改善後の保守と例外対応 | 削減が継続するか、別の仕事へ移っただけか |
| 利用者や業務への影響 | 工数だけでは表せない失敗・遅延・依存を減らせるか |
| 対象サービスの将来 | 廃止予定や仕様変更が近く、投資を回収できない対象ではないか |
一つの改善で回収できる見込みがあれば、対象を広げる材料になります。逆に、同じ作業の頻度が低く、近く廃止する仕組みなら、手順を簡単にするだけで十分なこともあります。SREを進めることと、何でも自動化することは同じではありません。
経営・開発・SREで何を決めるか
導入時には、サービスの重要性、必要な信頼性、改善時間、実装担当、優先順位を変える条件をそろえます。SRE担当者が数値を報告しても、新機能の計画が一切変わらなければ、指標は資源配分に使われません。
例えば、SLO未達が続いているのに営業施策に必要な機能追加も控えている場合、事業責任者が顧客への影響を整理し、開発責任者が両方の工数を見積もり、優先順位を決めます。担当部門で決められない投資は経営へ上げます。これも一つの設計例です。
任命する人材については、実際に運用してきた経験、変更を安全に実装する力、利用部門と改善条件を調整する力を、担当範囲と照合します。採用だけで足りなければ、既存メンバーの育成や外部支援と組み合わせます。
開発の速さを評価するときも、実装時間だけでなく、リリース後の手戻りや運用負担まで含めると、改善の意味を捉えやすくなります。作業の体感と実測の違いは、AIによる開発生産性の測定でも扱っています。
SREについてよくある疑問
小規模な会社にも専任SREが必要?
専任の職種を置くことが、実践の必須条件ではありません。反復作業や障害の影響が小さければ、既存チームによる計測と改善から始められます。一方、サービス数や運用の複雑さが増え、共通の改善を継続して担う仕事が大きくなれば、専任化を検討する理由になります。企業規模だけでなく、改善対象と仕事量で判断します。
SREを置けばセキュリティ対策も任せられる?
更新や権限設定、監視などは担当が重なりますが、SREは全社のセキュリティ統括と同義ではありません。情報の取り扱い、取引先への要求、事業停止の判断などは、他の責任者や部門との分担が必要です。担当者一人に追加するなら、専門知識だけでなく仕事量と権限も見直します。
どんな経験や資格から育成すればよい?
運用、ソフトウェア開発、クラウド、ネットワークなど、本人の経験を起点にできます。資格は知識の整理に使えますが、それだけで本番の変更や部門調整ができることを確認できるわけではありません。小さな改善を設計し、試験し、実施後の結果を確かめる経験を積み、足りない領域を周囲が支える育成が考えられます。
運用を改善する人と時間を、会社の計画に入れる
SREは、サービスの信頼性を測り、繰り返す作業や問題を改善して、運用負担と開発の速さを調整する取り組みです。導入を難しくするのは、大きくいえばリソースと人材です。
改善後に余力が生まれるとしても、着手時には時間と技能が必要です。技術の変更だけでなく、利用部門の仕事や新機能の優先順位を変えるなら、その合意をつくる役割も必要になります。
SREを取り入れるとは、運用担当者に改善も追加で頼むことではなく、必要な信頼性と改善対象を決め、そのために人と時間を配分することです。 自社の重要なサービスで、何を測り、何を減らし、誰が変更できるかまで決めると、取り組みが具体的になります。
参考資料
- Google SRE Book「Introduction」:SREの基本的な発想と運用の位置づけ。2016年版。
- Google SRE Workbook「How SRE Relates to DevOps」:DevOpsとの関係。2018年版。
- Google「Monitoring Distributed Systems」:監視、通知と主要な観点。
- Google「Embracing Risk」:信頼性、費用、開発機会の関係。
- Google「Implementing SLOs」:利用者の体験に対応する指標と目標の設計。
- Google「Example Error Budget Policy」:2018年の方針例。実際の採用率や最新の全社規則ではない。
- Google「Identifying and Recovering from Overload」:運用業務の上限の考え方と、2016年の過負荷への対応事例。
- Google「Eliminating Toil」:トイルの特徴、Moiraの取り組み、改善に伴う費用の考え方。
- Google「SRE Team Lifecycles」:専任者がいない状態からの実践と組織の成長。
- IPA「デジタルスキル標準ver.2.0 ビジネスアーキテクト編」:2026年4月。目的、業務設計、関係者の合意形成に関する役割。
- メルカリ「サービス基盤を守るSREチームが求めるEM」:2020年7月16日公開。当時の仕事と体制構想。
- LINEヤフー「開発・運用分離のリアル」:2026年5月27日公開。LINE Platformの分担と連携の説明。
- AWS「サイト信頼性エンジニアリングとは」、Red Hat「SREとは」:基本用語と関連する実践。
本記事の文章・表・図解・グラフは、Skill Business Architecture Labが独自に編集・作成しています。引用・紹介する場合は、引用箇所が分かる形で、記事名・サイト名・記事URLをご記載ください。
コメント