「もう自分ではClaudeにプロンプトを出していない」。AnthropicでClaude Codeの開発を率いるBoris Cherny氏の発言が、Addy Osmani氏の「Loop Engineering」で紹介されています。代わりに、何をするかを判断してClaudeへ指示するループを動かし、自分はそのループを作る、という働き方です。
驚くのは、コードを書く作業をAIに任せるだけでなく、AIの回答を見て次の指示を出す仕事まで、仕組みに移していることです。人の仕事は、一回ずつ「ここを直して」と伝えることから、何を確認し、どう直し、どこで完成とするかを設計することへ移ります。
この考え方は、記事制作にも置き換えられます。原稿を作るAIに、出典や説明を確認する工程をつなぎ、不足があれば修正へ戻す。ただし、一本の記事を完成させることと、公開後のアクセスを見て次の施策を決めること、売上計画に合わせて予算を配ることでは、必要な判断が違います。
ループエンジニアリングは、作業・検証・修正・記録・次の判断をつないで設計する考え方です。何をループさせるかを決めると、AIに任せたいことと、人が引き受ける判断が具体的になります。 この記事では、関連する技術やツールを整理し、同じメディア運営の例で、作業の反復から分析・改善、事業計画へと任せる範囲を広げて考えます。
ループエンジニアリングとは?「もうプロンプトを書かない」の意味
ループエンジニアリングで変わるのは、指示が必要かどうかではなく、誰が、どの結果を受けて、次の指示を出すかです。人が毎回確認していた部分のうち、条件を決められるものを仕組みに移します。
たとえば、AIに記事を書いてもらっても、出典の確認や説明不足の指摘を毎回人が引き受けていれば、人は作業のたびに呼び戻されます。そこで、繰り返し使える確認基準を先に決め、検証結果から次の作業へ進めるようにします。冒頭の発言は、指示の中身をなくすのではなく、指示を出す役割を変える話と捉えると分かりやすくなります。
人が毎回返していた指示を、検証結果から作る
例えば、AIが「商品Aは月額1,000円」と書いたとします。人が公式料金表と照合して「年払い時の月換算なので、条件を補って」と返すのが通常の往復です。
ループとして設計するなら、最初に「金額は公式資料と照合し、課金単位と適用条件を確認する」という検証基準を用意します。作成後にその基準で確認し、条件の欠落があれば、該当段落と修正理由を作業側へ戻します。修正版をもう一度確かめ、問題が解消したら完了として記録します。
ここで自動化されたのは、単なる再執筆ではありません。「何が不足したかを特定し、その不足に対応する修正を依頼する」という往復です。公式資料を取得できない場合には、同じ修正を繰り返すより、確認不能として人へ戻すほうが仕事は進みます。
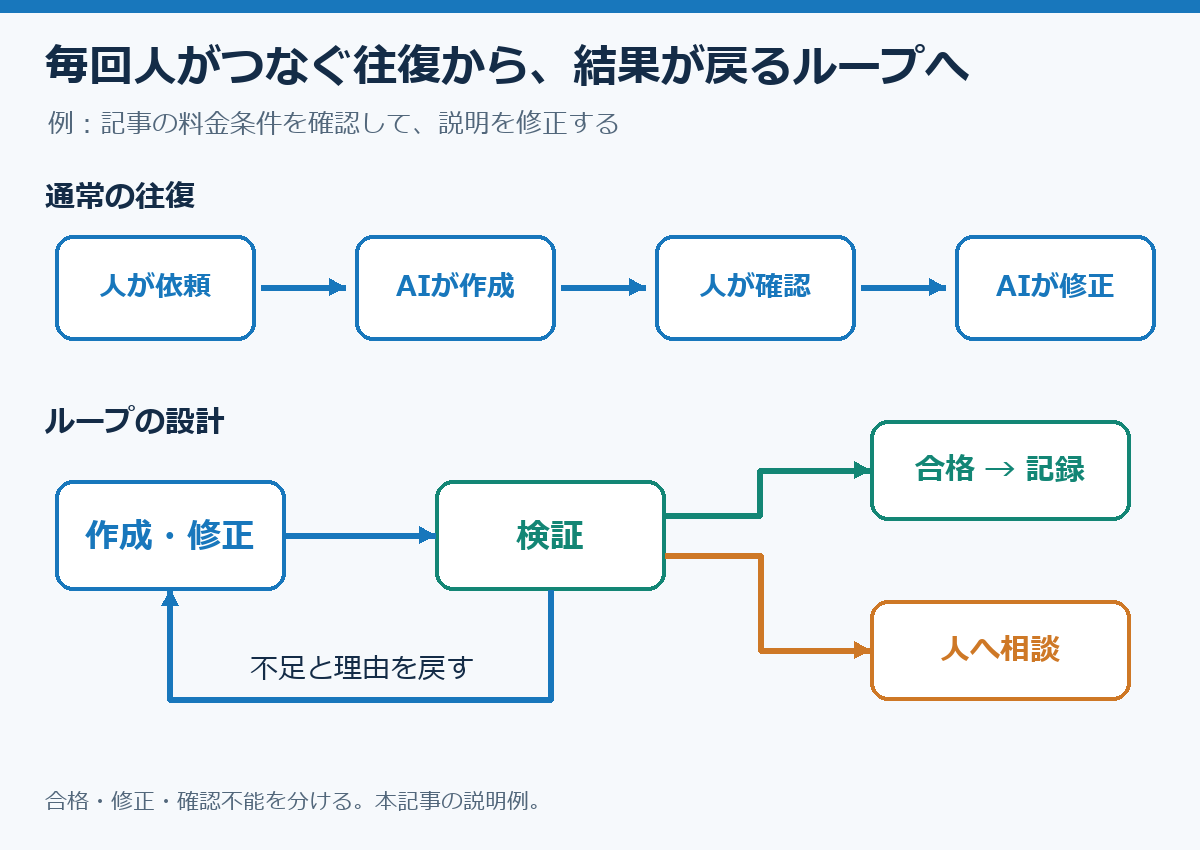
図の下段では、修正の矢印が作成側へ戻ります。一方、合格した成果物と、人の判断が必要な問題は別の出口へ進みます。「繰り返せる」だけでなく、「同じ問題を繰り返さずに終えられる」設計が重要になります。
定時レポートと、結果を使うループはどこが違うか
毎週月曜日にアクセス数を集計して送るだけでも、手作業の削減になります。ただし、その後に何をするかは受け取った人が考えます。
結果から次の仕事までつなぐなら、例えば「検索表示は増えているがクリックが伸びない記事を候補にする→検索語とタイトルの対応を確認する→変更案を作る→人が採用した案だけ反映する→変更日を記録する」といった流れになります。集計結果が、次の作業の入力になっています。
違いは実行回数ではなく、結果が次の判断に戻っていることです。毎日動かしても報告で終わる仕組みもあれば、一つの案件の中で検証と修正を繰り返す仕組みもあります。
プロンプト・コンテキスト・ハーネスとの違い
四つの言葉は、同じ仕事の別々の部分を指します。記事制作なら、何を頼むか、何を渡すか、何を使って作業できるか、結果を見て次に何をさせるかです。ループを取り入れても、指示や資料が不要になるわけではありません。
| 考え方 | 記事制作で決めること |
|---|---|
| プロンプトエンジニアリング | 何を頼むか |
| コンテキストエンジニアリング | 判断に何を渡すか |
| ハーネスエンジニアリング | 何を使って作業できるか |
| ループエンジニアリング | 結果を見て次に何をさせるか |
同じ「料金を説明する記事」で、四つの役割を見る
プロンプトは、「初めて使う人が料金プランを選べる記事にして」と頼む部分です。何を完成させたいのかを伝えます。
コンテキストは、その判断に使う材料です。公式料金表、想定する利用人数、読者が迷っている点、既存の原稿などを渡します。同じ指示でも、古い料金表しか渡さなければ、正しい比較は難しくなります。
ハーネスは、AIが仕事を進めるための道具と環境です。公式サイトを調べる機能や、原稿を編集・保存する機能がここに当たります。「最新料金を確認して」と頼んでも、サイトを読む手段がなければ確認できない、という違いです。
ループは、できた原稿を確認し、次の仕事へ戻す流れです。「年間契約の条件が抜けている」と分かったら、その箇所の修正を依頼し、修正後にもう一度確かめます。条件を満たしたら完成にし、資料を取得できなければ人へ戻します。
このように分けると、うまく進まない原因も探しやすくなります。目的が曖昧なら指示、情報が古ければ資料、調べられなければ道具、同じ誤りを繰り返すなら検証から修正へ戻す流れを見直す、という具合です。四つは新旧の優劣ではなく、一つの仕事を支える役割として組み合わせます。
AIエージェントとマルチエージェントは、実行する側の構成
AIエージェントは、目的に応じてツールを使い、必要な作業を進める仕組みです。複数のエージェントに役割を分ける構成を、マルチエージェントと呼びます。
例えば、原稿を作る役割と出典を検証する役割を分けると、作成時の説明をそのまま追認するだけにならないよう、確認の観点を変えられます。ただし、二つのAIが同じ誤った資料を読めば、両方が同じ結論に進むこともあります。人数を増やすことより、何を根拠に判定する役割なのかが大切です。
一つのAIが工程ごとに役割を切り替える方法もあります。別モデルを三つ契約すれば三段階の運用ができる、という関係ではありません。後半で紹介する段階も、モデル数ではなく、任せる仕事の範囲で分けています。
操作権限の考え方を深めたい場合は、AIエージェントのセキュリティと管理範囲でも、情報へのアクセスと実行できる操作の違いを扱っています。
Claude Codeの /loop とRalph Loopは何ができるのか
ループエンジニアリングは考え方の名前です。一方、Claude Codeの /loop は実行を繰り返す機能、Ralph Loopはコーディングエージェントを反復実行する手法です。これらを使うことと、業務全体の判断を設計することを分けると、導入時の期待も合わせやすくなります。
/loopは繰り返すきっかけ、/goalは到達条件に向かう機能
Claude Codeの公式資料では、/loop はセッション内でプロンプトを繰り返し実行する機能として案内されています。間隔を指定して状況確認を行う使い方などがあり、目標条件に向けて作業を継続する /goal とは区別されています。
記事運営に置き換えると、「一定間隔で新しいレビュー結果が届いたか確認する」のは繰り返しのきっかけです。「指摘が残っていれば直し、合格したら終える」のは、その後の判断です。定期実行だけ設定しても、何を直し、何を変えず、いつ終了するかまでは決まりません。
また、/loop は稼働中のセッションを前提とする方式です。PCを閉じても独立して動くクラウドの定期タスクとは実行場所が違います。利用する環境を選ぶ際は、参照したいファイルや接続先と、実行を続けたい時間を合わせて考えるとよいでしょう。公式のスケジュール機能比較では、その違いが整理されています。
Ralph Loopは、一回の回答で終わらせず作業を進める手法
Geoffrey Huntley氏が紹介するRalphは、コーディングエージェントを反復させる手法です。考案者の説明では、仕様や作業計画を参照し、一回の反復で一つの仕事に取り組む構成が示されています。
業務への応用を考えるうえで参考になるのは、「もう一度」とだけ頼むのではなく、次の実行が現在の成果物と未完了の仕事を読めるようにする点です。記事の出典を一つ直したなら、その修正を残し、次は未確認の出典へ進める。前の成果が残らなければ、何度呼び出しても同じ説明から始まってしまいます。
Ralphという名称の実装やプラグインは複数あり、考案者自身も一部の実装との違いに言及しています。ここでは特定プラグインの操作法ではなく、反復と状態の引き継ぎという手法として扱います。
AIに任せる範囲を、三つの段階で考える
実務では「ループを導入するか」だけでなく、「どこまでを一つのループにするか」が選択になります。ここからはメディア運営を例に、単作業、作業同士の接続、事業計画を含む運用の三段階で見ていきます。
L1〜L3は本記事独自の説明枠組みです。 製品の公式レベルや成熟度の認定ではなく、何の結果を何へ戻すかを整理するために使います。以下のメディアと売上目標も説明用の仮定です。
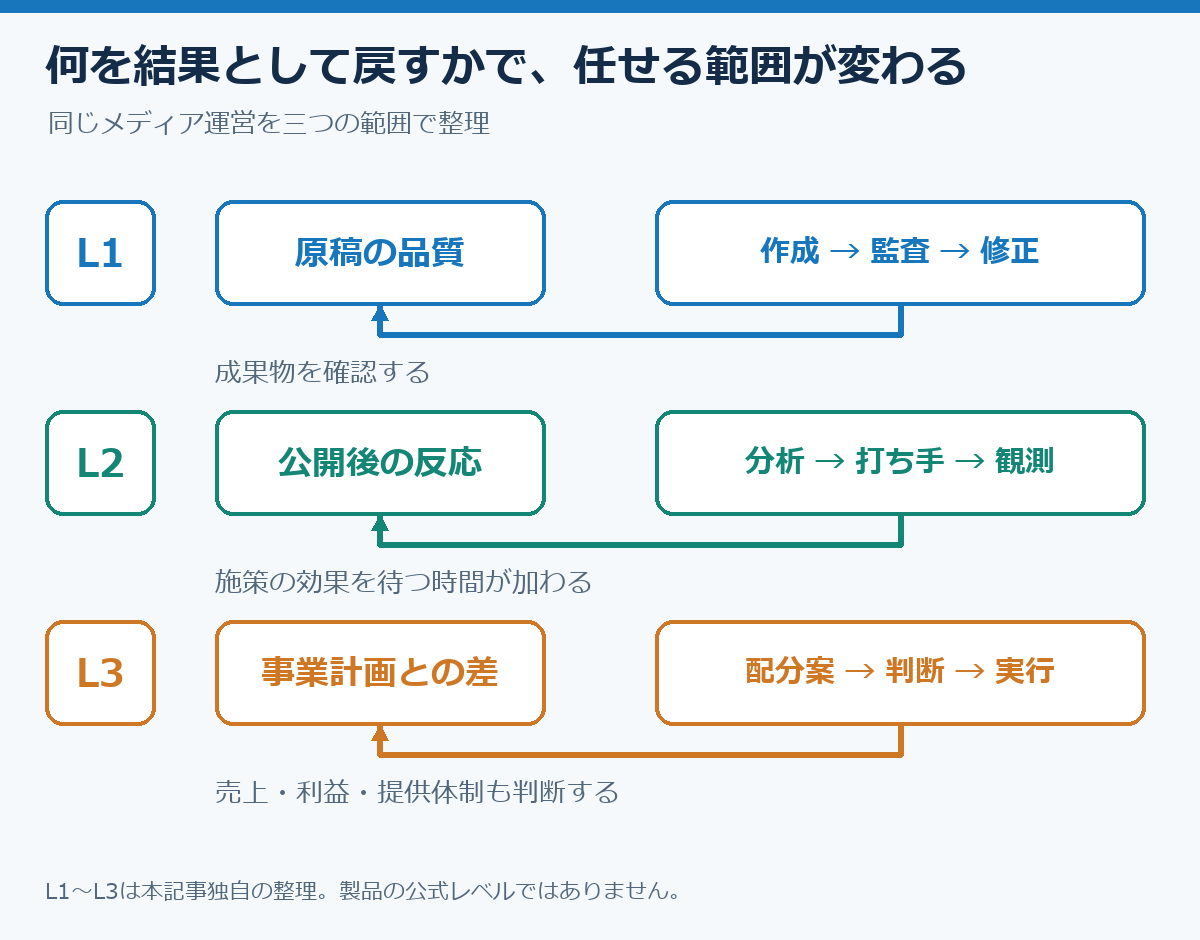
図の三段階では、同じ記事制作を含んでいても、合格を判断する物差しが変わります。原稿が正しいこと、記事が読まれること、事業に利益が残ることは、それぞれ別の結果だからです。
L1:一つの記事を、作成・監査・修正で仕上げる
最初の段階では、対象を記事一本に絞ります。渡すものは、読者の疑問、採用した論点、参照資料、既存原稿などです。返してほしいものは、条件に合う原稿と確認記録です。
例えば、あるツールの紹介記事で「無料で利用できる」とだけ書かれていたとします。監査側は、無料枠の上限や有料機能との境界が説明されているかを原資料で確かめます。読者が判断を誤る不足があれば、その理由と修正対象を戻します。
修正側が「条件を追記しました」と報告しても、それで終わりにはしません。監査側が新しい本文を読み、料金条件が正しいことと、説明が初見の読者にも理解できることを確かめます。修正前の原稿を検証してしまわないよう、どの版を読んだかも残します。
ここでは、事実確認と読者への説明は別の観点です。公式料金を正しく転載しても、課金単位が「利用者」なのか「組織」なのか分からなければ、自社でいくらかかるかを判断できません。機械的なリンク確認だけで合格にせず、読者の疑問に答えた本文を確かめる役割が生きてきます。
逆に、意味が通じる文章を何度も言い換え続ける必要はありません。「料金条件が正確」「重要な機能の対象が分かる」「採用した疑問に答える」といった終了条件を置くと、好みの修正でループが終わらなくなることを抑えられます。
L1は、成果物と確認基準を狭く定めやすいため、小さく試しやすい段階と考えられます。人は毎段落の修正指示から離れ、例外や最終成果物の判断に時間を使う形を目指せます。
L2:公開後の分析から、新規作成・改稿・待つを選ぶ
二段階目では、記事を仕上げたところから先へつなぎます。Google Search Consoleで検索上の反応を、Google Analyticsで訪問後の行動を確認し、その結果から次の仕事を決める例です。
Search Consoleの表示回数は、検索結果にページが表示された回数です。クリックはそこから訪れた入口になります。Analyticsでは、訪問後に記事を読み、問い合わせや購入などの行動に進んだかを、設定した計測条件に沿って見ます。CVはこうした目的行動、CVRはその割合を表します。
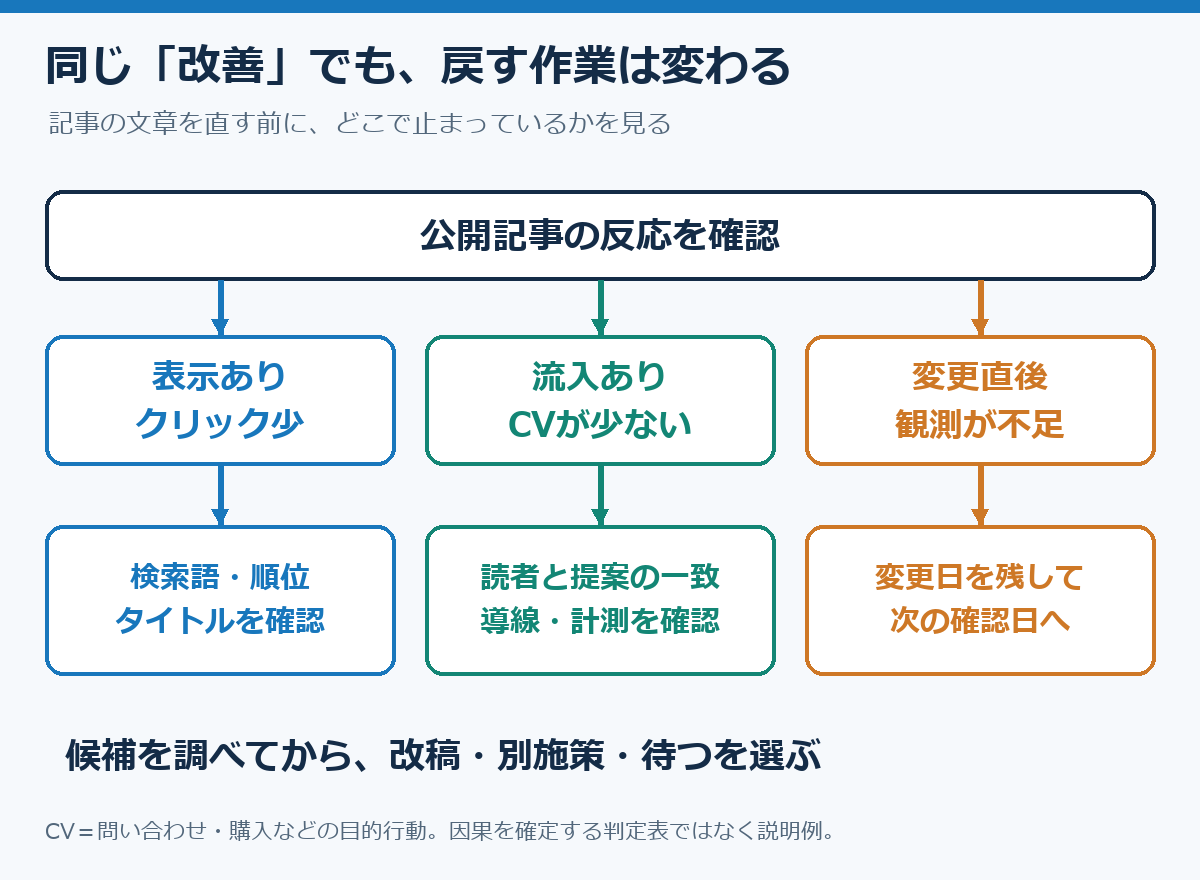
例えば、表示はあるのにクリックが少ない場合、まず実際の検索語と、表示されているタイトルや説明が合っているかを見ます。検索順位や検索結果上の他の要素でもクリック率は変わるので、「低いからタイトル変更」と直結させず、検索者が期待する答えを確かめます。
一方、流入はあるのに問い合わせが少ないなら、タイトルよりも、記事を読む人と提案するサービスが合っているか、比較に必要な情報があるか、申し込み先へ進めるかなどが候補になります。フォームの計測が動いていないだけなら、本文を書き換える前に計測を直すほうが適切です。
この二つを同じ「記事を改善する」という指示にまとめると、原因を調べる前に文章の修正へ進んでしまうおそれがあります。分析結果から、どの疑問を調べ、何を変更候補にするかまでつなぐことで、改善の対象が具体的になります。
そして、L2には何もしないで待つ判断も含まれます。公開直後や変更直後は、検索に反映される時間や、比較に必要なデータが足りないことがあります。変更のたびにすぐ再改稿すると、どの変更がどう影響したかを追えなくなります。
そのため、記事ごとに変更日、狙い、比較する期間、次の確認日を残します。十分なデータがない時には作業を増やすのではなく、観測待ちの状態に置きます。固定の一日間隔でAIを動かすことと、施策を評価できる間隔は別に考えるとよいでしょう。
L2が設計次第になるのは、データを取得する接続だけでなく、計測条件、問題の切り分け、変更を許す範囲までそろえるためです。ここまで決まれば、AIはレポート作成だけでなく、根拠のある次の作業案まで準備しやすくなります。
L3:売上計画を含め、優先順位や予算を見直す
三段階目は、記事単体の結果を事業計画へ戻す段階です。仮に「一年後に年間売上1,000万円を目指す」という計画があるなら、流入数だけでなく、目的行動、受注、単価、提供できる量なども判断材料になります。
例えば、記事経由の問い合わせは増えているのに売上が伸びない場合、記事の本数が足りないとは限りません。問い合わせ内容とサービスが合っていない、見積もり後に失注している、受けられる案件数が埋まっている、といった場所に原因があるかもしれません。
反対に、成約率も提供体制も安定していて、見込み客との接点だけが足りないなら、記事制作や広告へ追加投資する判断が候補になります。同じ「売上未達」でも、増やす仕事は変わります。
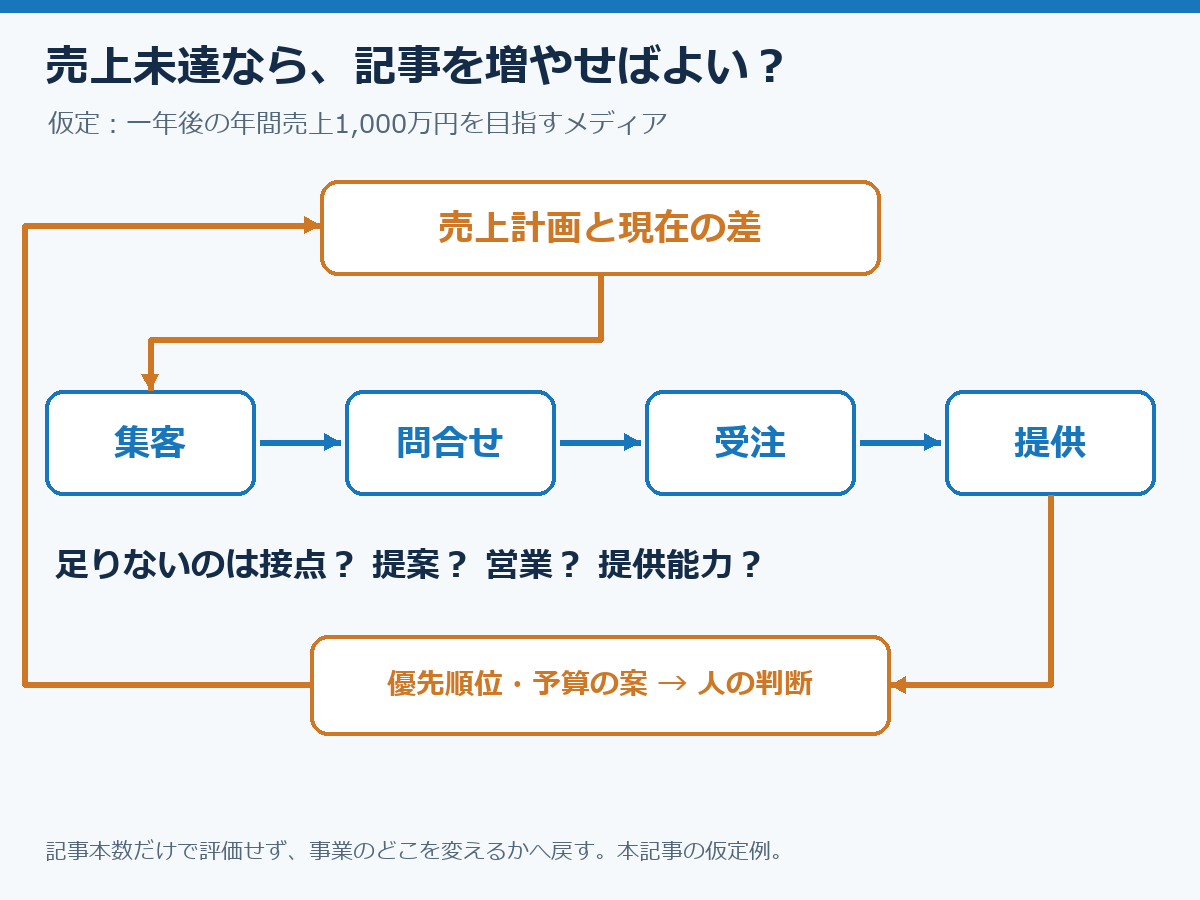
L3では、分析AIが数値の変化を見つけ、管理機能が進捗と予算を照合し、優先順位の案を作る、といった支援が考えられます。ただし、事業の方向や価格を変えることは、計算上の改善だけでは決まりません。顧客との約束、営業体制、利益、ブランドをどう扱うかも関わります。
さらに、目標の置き方そのものが行動を変えます。流入数だけを最大化するなら、売上につながりにくくても閲覧される題材を増やす選択が起こり得ます。売上だけなら、値引きや広告投下で利益を減らして達成する案も考えられます。AIが目標に沿って動いていても、事業として望む結果から離れることがあります。
このため、現時点でL3を全面委任するより、情報収集、差分の発見、選択肢と根拠の整理までを任せ、重要な配分や計画変更を人が決める設計が現実的だと考えます。これはAIの将来性能の断定ではなく、評価に時間がかかり、複数の利害を含む今回の業務条件からの見立てです。
ループを支えるのは、記録・検証・人へ戻す条件
自動化を広げるとき、最初に増やしたいのはAIの役割数よりも、作業の状態が分かる記録です。「何をしたか」だけでなく「何を確かめ、次に何を待っているか」が分かると、同じ確認や修正を繰り返しにくくなります。
会話の続きだけに頼らず、次の実行が読める記録を残す
記事制作なら、対象原稿、採用した論点、未確認の出典、修正理由、検証した版、次の作業を残します。公開後の分析までつなぐなら、変更日と評価予定も加わります。
例えば「料金の説明を修正した」という記録だけでは、次の担当はどこを直したのか再調査します。「年払い条件が欠落していたため料金段落へ追加し、公式ページと照合済み。次は比較表の同じ条件を確認する」まで分かれば、作業の戻り先が明確です。
記録は長い日記である必要はありません。現行の決定と古い案が混ざらず、次の実行が必要な情報へ戻れることが大切です。指示を毎回長く貼り直す負担を減らすには、参照する状態も更新されていく仕組みが役立ちます。
合格基準と、作業範囲の変更を分ける
記事の検証中に「関連テーマも書いたほうがよい」と気づくことがあります。それは今の記事の修正なのか、新しい仕事なのかを分けて扱うと、ループが勝手に広がることを防げます。
例えば、現在の記事で用語の説明が一文足りなければ、その場で補えます。一方、別製品の比較記事を追加するなら、調査や制作の予算が増えます。新しい仕事の候補として記録し、現在の原稿を完成させてから判断する設計も考えられます。
合格基準は、何でも追加するためのリストではなく、今回約束した価値を満たしたかを見るものです。作成側と検証側の両方が同じ範囲を参照すると、改善のつもりで主題が変わることも減らしやすくなります。
止まることも、ループの正常な結果にする
出典を取得できない、外部サービスの保存結果が不明、修正しても同じ誤りが続く。こうした場合には、追加実行よりも人の判断が役立ちます。
その際に「エラーです」だけを返すと、人が最初から調べ直します。「何をしようとしたか」「どこまで完了したか」「結果は失敗か不明か」「何が分かれば再開できるか」があると、介入は短くなります。特に保存の結果が分からない場合、同じ保存を繰り返す前に、実際に作成されたかを確認する仕事へ戻すことが重要です。
費用にも同じ考え方が使えます。検証と修正を繰り返すほど、AIの利用料と時間は増えます。試行段階では一回の案件に使える費用や反復回数の上限を設け、上限に達したら成果物と残課題を渡す形にすると、終わらない改善を避けやすくなります。
ループエンジニアリングの始め方:まず一つの改善を最後までつなぐ
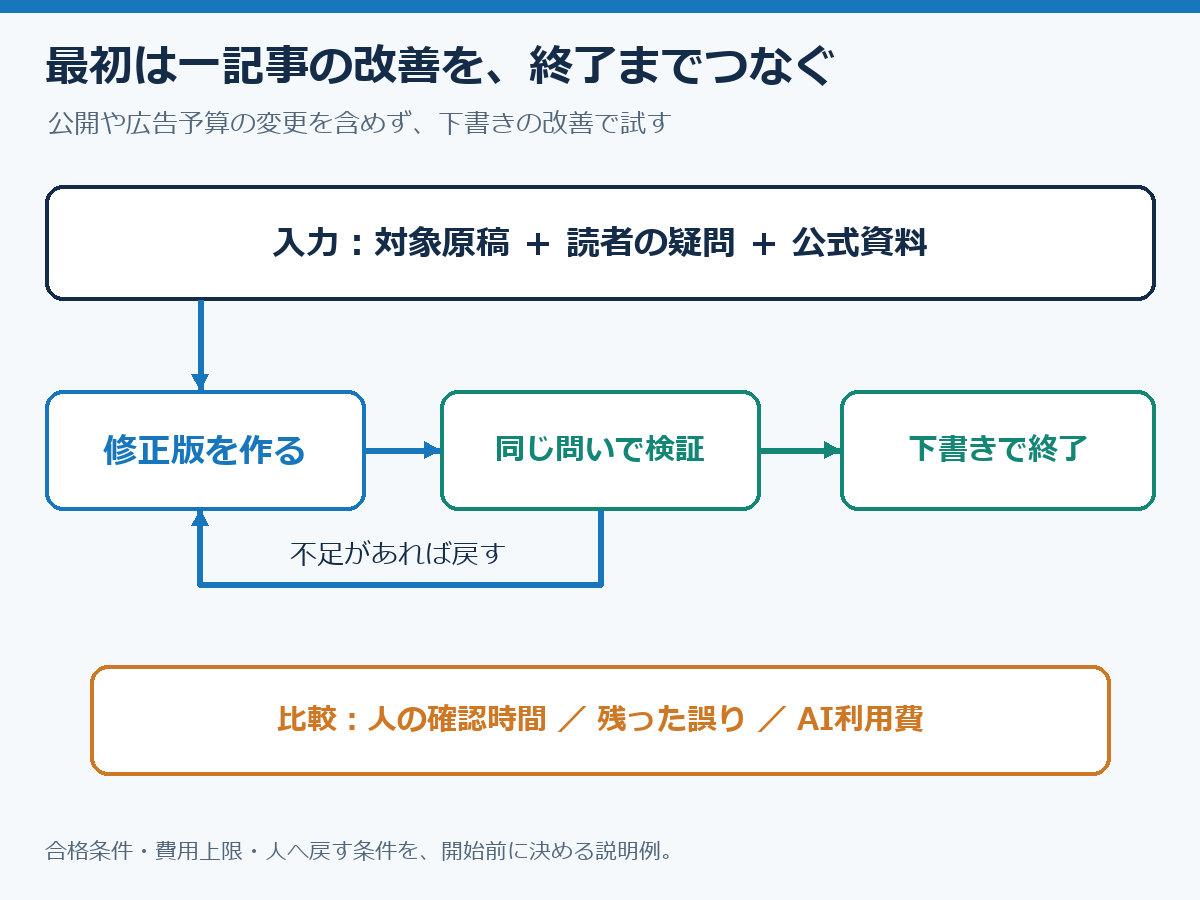
最初の試行には、成果が見えるまでの時間が短く、対象を戻せる仕事が向いています。例えば、既存記事一本の出典と説明を確認し、修正版を下書きとして作る範囲です。公開や広告費の変更は含めず、まず制作と検証の往復を試します。
最初に渡すものを、小さな仕事の単位でそろえる
「良い記事にして」という依頼だけでは、何が良いかを毎回AIが推測します。対象の記事、読者の疑問、参照してほしい資料、変更してよい範囲、終わりの条件をまとめると、修正の方向を合わせやすくなります。
例えば「料金と対象機能の説明を、初めて使う人が比較できるようにする。公式資料で確認し、未確認事項は作らない。関係のない章は変更せず、下書きで止める」という単位です。機械的に全項目を埋めるより、どの疑問を解消する仕事なのかが伝わることを優先します。
そのうえで、作成側は修正版、検証側は修正が必要な本文箇所と理由を返します。検証結果を受けて修正し、同じ疑問に答えられたかを再確認する。この小さな往復が安定してから、対象記事や接続する作業を広げると、問題の場所も追いやすくなります。
成功は、生成量よりも人の負担と品質で確かめる
一時間で何本作ったかだけでは、試行の価値は判断できません。確認と修正に人が以前より時間を使うなら、作業の場所が変わっただけかもしれません。
同程度の記事で、人が読んで確認する時間、修正指示の回数、残った重要な誤り、AIの利用費を見比べると、任せる価値が分かりやすくなります。公開後の成果を評価するL2へ進む前に、L1の品質が安定しているかを見るための比較です。
もし毎回「説明が足りない」と人が戻しているなら、単純に反復を増やすより、検証側が読者の疑問を確かめられているかを見直す余地があります。逆に、事実確認は安定していても保存で止まるなら、実行環境や権限の問題です。結果を見て設計のどこを直すかまで考えると、試行そのものが次の改善材料になります。
まとめ:AIの数より、何を結果として戻すか
ループエンジニアリングは、AIへの指示をなくす技術ではなく、毎回人がつないでいた作業と判断を仕組みへ移す考え方です。プロンプトや参照情報、実行環境を整えたうえで、結果を検証し、修正し、記録して次へ進みます。
記事一本なら、原稿の品質を見て修正へ戻せます。公開後の運用なら、検索や訪問後の反応から、新規作成・改稿・観測待ちを選びます。事業計画まで含めるなら、流入以外の受注・単価・提供体制も見ながら、予算と優先順位を考えることになります。
任せる範囲を広げるほど、AIに必要な情報だけでなく、何を成果とするかという設計も広がります。 最初は一つの改善を、検証と終了までつないでみる。その結果、人の確認負担が減り、必要な品質を維持できたなら、次の作業との接続を検討する。この進め方なら、ツールの名前に引っ張られず、自分の業務で役立つループを育てやすいのではないでしょうか。
参考資料
- Addy Osmani「Loop Engineering」(2026年6月7日):概念、仕事と検証・記録をつなぐ設計。著者の見解と製品仕様を区別して参照。
- Claude Code公式「Run prompts on a schedule」:/loop、/goalとの区別、セッションと実行環境。
- Geoffrey Huntley「Ralph Wiggum as a software engineer」:Ralphの考案者による手法説明。個別の成果談は一般的な性能として使用していません。
本記事の文章・表・図解・グラフは、Skill Business Architecture Labが独自に編集・作成しています。引用・紹介する場合は、引用箇所が分かる形で、記事名・サイト名・記事URLをご記載ください。
コメント