「機密情報を外部に送らずにAIを使いたい」。この目的で注目されるのが、自分のPCや管理するサーバーで動かすローカルLLMです。社内文書の要約や独自の業務支援など、正当な用途が数多くあります。
一方、同じ仕組みは、AIサービス会社の監視や利用停止が届かない環境でもAIを動かせることを意味します。ローカルLLMの危険性を理解する鍵は、AIが手元にあることそのものより、「誰が、そのAIの動作と利用を管理できるのか」です。
公開されたモデルを自主管理する環境で悪用した活動は、すでに報告されています。守る企業にとっての問題は、未知の攻撃が突然あらゆる防御を破ることだけではありません。既知の弱点を調べ、試し、次の対象へ進む作業が効率化すれば、修正の遅れや担当不明のシステムが、これまで以上に放置しにくくなります。
この記事では、Ollama・LM Studioなどの用語を整理しながら、ローカルLLMの便益、提供会社の制御が及ぶ範囲、確認された悪用と将来予測の違いを説明します。そのうえで、AIを使う会社だけでなく、Webサイトや顧客データを持つ経営・事業・マーケティング担当者が何を確認すべきかを考えます。
ローカルLLMとは?クラウド型AIとの違いは実行場所と管理の主体
LLMは文章を扱うモデル、ローカルは動かす場所
LLMは、大量のデータから学習した大規模言語モデルです。入力された文章に応じて文章を生成し、要約、翻訳、質問への回答、プログラム作成などに利用されます。
普段のAIサービスでは、画面に入力するとサービス会社のサーバーで処理され、回答が戻ります。ローカルLLMでは、モデルのファイルを取得し、手元のPCや社内のサーバーなどで処理します。クラウドの画面をPCで開いているだけなら、処理までローカルになったわけではありません。
ここで「モデル」と「使うためのソフト」を分けると理解しやすくなります。モデルは学習済みの計算の仕組みであり、それを読み込んで動かす実行ツール、質問や回答を表示する画面と組み合わせて利用します。製品によっては、実行ツールと画面を一つにまとめています。
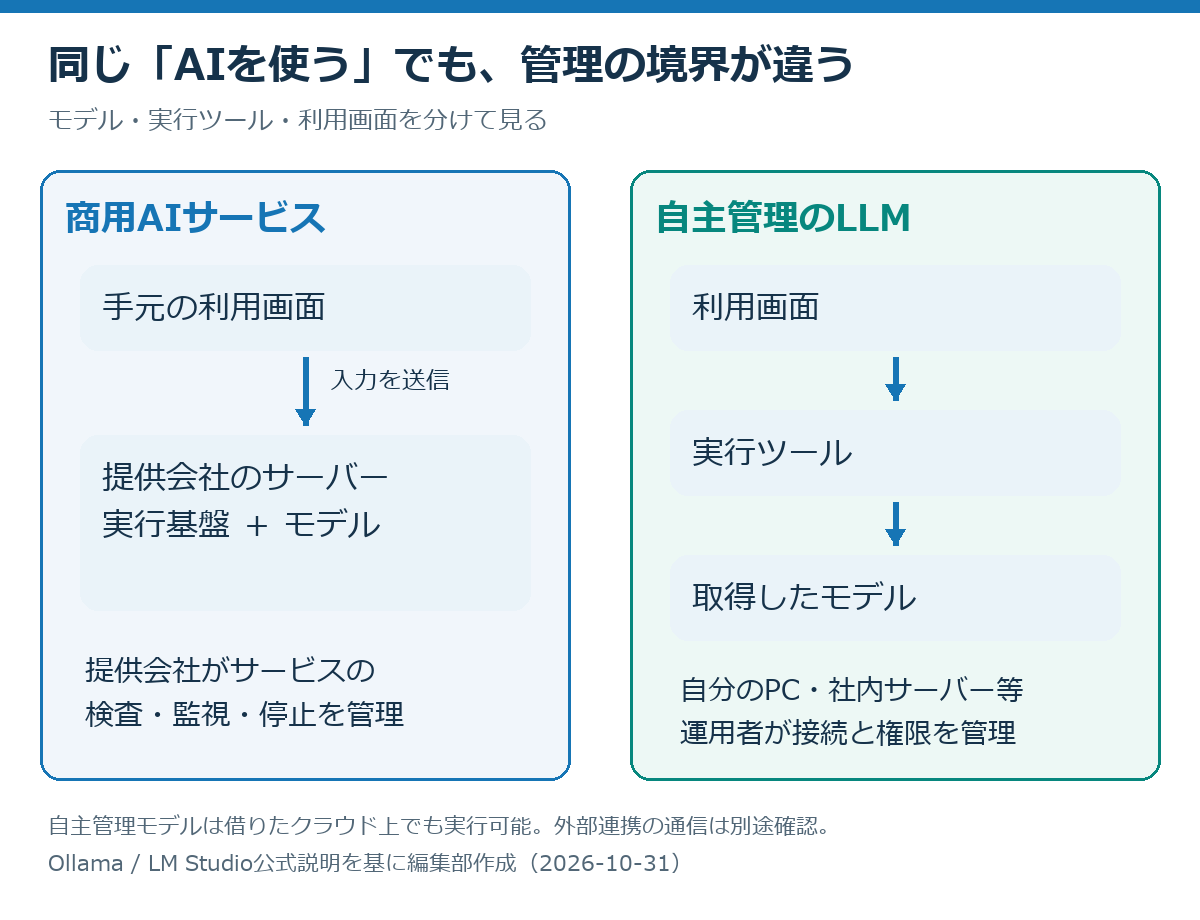
図は処理と管理の境界を理解するための模式図です。自主管理でも外部サービスを接続すれば通信は発生します。モデルを動かす仕組みはOllama公式、LM Studio公式を参照しています。
プライベートLLM・個人LLM・オープンウェイトは同じ意味か
「ローカルLLM」「プライベートLLM」「個人LLM」は近い文脈で使われますが、同じ条件を表す名称ではありません。プライベートという言葉が、社内だけで使う専用環境を指す場合、その環境はクラウド上にあることもあります。個人LLMも、個人が管理することを強調する呼び方で、処理場所を一意に決める技術用語ではありません。
| 言葉 | 主に表すもの | 確認すること |
|---|---|---|
| ローカルLLM | 手元や自組織の環境での実行 | 回答を計算する処理はどこか |
| プライベートLLM | 利用者やデータへのアクセスを限定した環境 | 専用環境の管理者と通信先は誰か |
| 個人LLM | 個人用途・個人管理を意識した呼び方 | 個人PCで動くのか、外部サービスなのか |
| オープンウェイト | 学習済みの重みを入手できる公開形態 | 利用条件と、取得後にできること |
表は用語の整理です。「非公開だから安全」「個人用だから外へ送らない」と名称で判断せず、処理場所、利用者、管理者、外部接続の四つを確認する必要があります。
もう一つ重要なのが、自主管理モデルをクラウド上のサーバーで動かすケースです。実行場所は借りたクラウドでも、商用AIの回答APIを利用するのではなく、自分でモデルを動かすことができます。APIは、他のソフトから処理を呼び出す窓口です。後で扱う悪用事例も、サービス会社の窓口を通るかどうかが重要になります。
OllamaとLM Studioは何が違う?モデルとツールを整理する
Ollamaとは?LLMを自分の環境で動かすためのツール
Ollamaは、LLMを取得・実行・管理するためのツールです。モデルの名前ではありません。LlamaはMetaのモデル系列なので、「OllamaとLlamaの違い」は、動かすための道具と、動かされるモデルの違いです。
Ollamaではアプリやコマンド操作、他のソフトから呼び出すAPIなどを利用できます。技術者が業務システムへ組み込む場面にも、手元で対話する場面にも使われます。「黒い画面に命令を入力する人だけの道具」と理解すると、現在の提供形態を取り違えます。
ただし、Ollamaにはクラウドモデルを利用する機能もあります。インストールしたソフトの名前だけで「入力は絶対にPCから出ない」と判断できません。公式FAQはローカル利用とクラウド利用を分け、クラウド機能を無効化する設定も案内しています。業務導入では、実際に選択するモデルと設定を確認します。Ollama公式FAQ
LM Studioでは、取得したモデルをオフラインでも使える
LM Studioも、手元でモデルを動かすためのアプリです。画面からの対話に加え、他のアプリから利用するAPIやコマンド操作などを備えています。「Ollamaはコマンド、LM Studioは画面」という二分法より、利用者が扱いやすい画面、システム連携、管理方法のどこを重視するかで比較する方が実務的です。
LM Studioの公式説明では、モデルを取得した後の対話や文書処理などはオフラインで利用できます。一方、モデルの検索・ダウンロード、実行用コンポーネントやアプリの更新にはネット接続が必要です。導入時に通信することと、毎回の質問を外部AIへ送ることは別の話です。LM Studioのオフライン利用
| 比較軸 | Ollama | LM Studio |
|---|---|---|
| 役割 | モデルの実行・管理、アプリやAPIでの利用 | モデルの実行、対話画面、APIなどでの利用 |
| 操作の入口 | アプリ、コマンド、APIなど | アプリ、コマンド、APIなど |
| ローカル処理 | ローカルモデルを選んだ構成 | 取得済みモデルを手元で実行する構成 |
| 注意する境界 | クラウドモデルを使っていないか | 外部連携や更新時の通信は何か |
| 企業で比較する点 | 配布・更新・連携を誰が管理するか | 利用者の操作と運用管理を両立できるか |
機能の整理はOllamaの案内、LM Studioの案内によります。どちらも導入すれば自動的に社内の情報管理が完成する製品ではなく、利用範囲と運用設計を決めて使う道具です。
Llama・Qwen・Gemmaはモデルの系列
ツールを決めた後にも、どのモデルを動かすかという選択があります。Llama、Qwen、Gemmaなどはその候補となるモデル系列です。
| モデル系列 | 提供元 | 選ぶ際に確認すること |
|---|---|---|
| Llama | Meta | 対象版の利用条件、必要な計算資源、業務での回答品質 |
| Qwen | AlibabaのQwenチーム | 同上。系列内でもモデルの規模や用途が異なる |
| Gemma | 同上。対応する実行環境や配布形式も確認 |
出典:Llama公式、Qwen公式、Gemma公式。系列名だけで、日本語の品質、商用利用条件、PCでの動作を一括判定することはできません。
たとえば同じ文章の要約でも、社内の略語を正しく解釈できるか、長い資料の条件を落とさないか、必要な時間で回答するかは業務によって異なります。人気のモデルを選ぶことと、自社で使えることの間には、実際の文書と評価基準による確認が必要です。
オープンウェイトとは?自由に動かせることが価値になる理由
学習済みの「重み」を入手すると、提供元のサービス外でも動かせる
モデルの「重み」は、学習によって調整された大量の数値です。利用者が一つずつ読む資料ではなく、入力から出力を計算する際に使うモデルの中核と考えるとよいでしょう。
オープンウェイトでは、この学習済みの情報が配布され、対応する環境でモデルを動かせます。毎回、開発元のAIサービスに処理を依頼する形だけでなく、自分たちの運用に組み込めることが価値になります。
一方、オープンソースAIという言葉は、重みが入手できることだけを意味しません。OSIの定義では、利用・研究・改変・共有の自由に加え、改変に必要な情報やコードなども扱います。公開モデルであっても利用条件はさまざまなので、企業では対象モデルのライセンスを確認します。OSI Open Source AI Definition
機密保持・オフライン・独自調整の便益と、その対価
ローカルで処理を完結できれば、入力文書を外部のAI処理へ送らずに済みます。ネット接続を制約した業務や、独自の評価基準でモデルを選びたい用途にも意味があります。
ただし、手元で動かすことは無料で運営できることと同義ではありません。機器、電力、更新、利用者への説明、回答の検証、障害対応を自分たちで引き受けます。モデルの利用料だけで比較すると、クラウド利用で提供会社に任せていた仕事が見えなくなります。
| 得られる自由 | 業務での価値の例 | 自分たちに残る仕事 |
|---|---|---|
| 処理場所を選ぶ | 社内文書を管理下で処理する | 保存先・閲覧権限・端末管理 |
| 接続を限定する | オフラインで必要な作業を続ける | 安全な取得・更新方法の設計 |
| モデルを選ぶ | 用途に応じて品質や速度を比較する | 誤りの評価とモデル変更の検証 |
| 業務へ組み込む | 社内資料を参照して回答する | 文書ごとのアクセス権と出力確認 |
表の業務例は導入判断を説明するための整理です。特定企業での効果実績を示すものではありません。
たとえば営業資料を要約するだけなら、担当者が回答を確認して使う運用を組めます。同じモデルに顧客データベースの検索やメール送信まで任せるなら、閲覧可能なデータ、送信の承認、誤作動時の停止方法まで必要になります。自由度が高いほど、使う側が決める範囲も広がるのです。
公開モデルの価値とリスクは表裏にあります。正当な利用者が自分の環境で改良できる一方、悪意のある利用者にも変更の余地があります。国際AI安全性報告2026も、公開ウェイトの便益と、配布後の監視・制御の難しさを併せて扱っています。
AIのガードレールとは?悪用を防ぐ仕組みと制御の限界
「危険な質問を断る」だけが安全対策ではない
AIのガードレールは、用途や方針に沿ってAIの入出力などを制約する仕組みを指します。たとえば禁止する内容を検査したり、機密情報を含む出力を止めたりします。AWSのGuardrailsでも、入力や応答に対して設定したポリシーを適用する仕組みが説明されています。Amazon Bedrock Guardrails
ただし、モデル自体を安全に応答するよう調整すること、入出力を検査すること、サービス運営者が利用状況を監視してアカウントを止めることは、働く場所が違います。さらにAIが外部のシステムを操作するなら、その操作権限も別に管理しなければなりません。
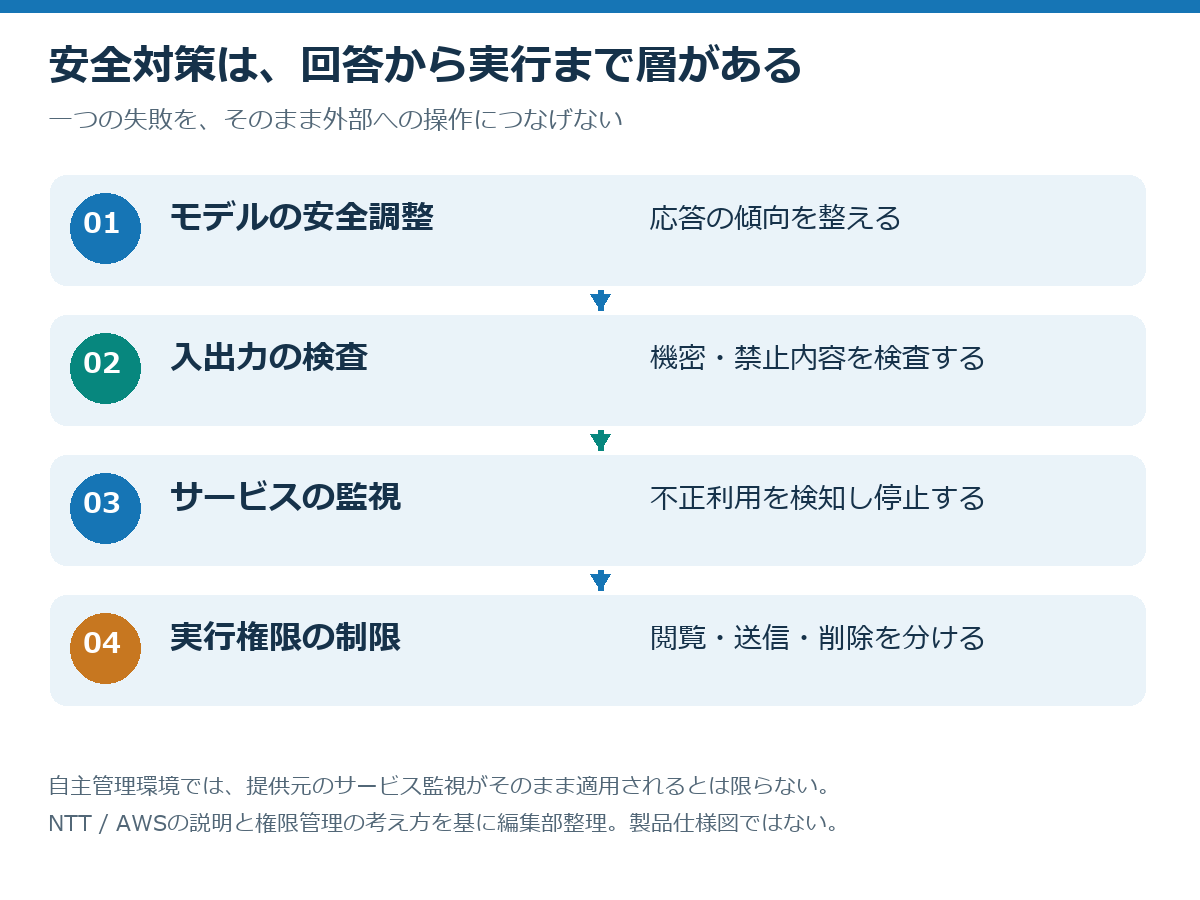
図はNTT技術ジャーナルとAWSの説明を基に、事業運用上の権限管理を加えて整理したものです。特定製品に四層すべてが自動実装されるという意味ではありません。
たとえば「顧客情報を外へ送ってはいけない」とAIへ指示するだけでは、送信権限そのものは消えません。誤った回答が出たときにも実行できないようにするのが権限管理です。回答の内容を検査する層と、そもそも実行できる操作を限定する層を重ねることで、一つの失敗を被害へ直結させにくくします。
回答だけでなく操作まで任せる場合の管理は、AIエージェントのセキュリティと権限管理で、調査と事故例から詳しく整理しています。
提供会社は、自社サービスの外で動くコピーを一括停止できない
AIサービス会社が運営するAPIでは、同社が通信を受け付け、利用を制限し、問題のあるアカウントを停止できます。もちろん検知や制限が完全とは限りませんが、運営する場所に制御の接点があります。
公開ウェイトを取得し、別の管理者が動かす環境では、そのサービスの窓口を通りません。提供元が新しい安全対策を公開しても、既に配布されたすべてのコピーへ更新を強制したり、利用を一括停止したりすることは難しくなります。
ここで失われるのは、モデルに一切の安全機能があるかないかという単純な区別ではなく、サービス運営者が使える監視・停止・更新の経路です。安全に調整された公開モデルもありますが、悪意ある運用者がその調整を維持する保証はありません。国際AI安全性報告2026
| 制御する場所 | 商用AIサービスを利用 | 自主管理モデルを利用 |
|---|---|---|
| モデルの応答傾向 | 提供会社が選んだモデル・調整 | 運用者が選ぶモデル・調整 |
| 入出力の検査 | サービス側の仕組みを適用可能 | 運用者側の実装・設定に依存 |
| アカウント停止 | 運営サービスへの接続を止められる | 開発元のサービスを通らない利用には届かない |
| 機器やデータへの権限 | 連携先も含めて別途管理 | 自組織で接続先・権限を管理 |
表は管理構造の比較で、製品ごとの安全性ランキングではありません。企業が正当に使う場合も、委託先へ「AIに安全対策はありますか」と聞くだけでは不足します。何を検査し、誰が止められ、停止した場合どの業務が残るかまで確認すると、回答の意味が明確になります。
ローカルLLMの悪用は起きているのか?観測された事実を読む
侵害したクラウドにモデルを置く活動が報告された
Googleの脅威調査組織GTIGは2026年9月の報告で、UNC6508との関連が疑われる活動が、侵害したクラウド環境にローカルLLMの基盤を展開したと説明しています。公開ウェイトのモデルを使い、商用AIのAPI監視を避けるとともに、被害者の計算資源を利用していたという観測です。GTIG報告
これは「犯罪者が自宅のPCでAIを使った」という話に限定されません。借りた、あるいは侵害したサーバー上でも、AIサービス会社の回答APIを経由せずにモデルを動かせる点が重要です。クラウドという場所を使っていても、商用AIサービスの監視が同じように働くわけではないのです。
この事例が示すのは、提供会社の利用規約やアカウント停止だけを犯罪利用への唯一の歯止めとして考えられないことです。モデルへのアクセス、実行する計算資源、攻撃対象の管理という複数の地点で対処する必要があります。
ただし、文章を生成するモデルと、他者のシステムへ接続して操作する仕組みは別です。攻撃者がAIを調査やプログラム作成の補助に使う段階と、外部の道具を接続して作業を繰り返させる段階では、できることが変わります。モデルを取得するだけで、他社の情報を自由に読めるようになるわけではありません。
自主管理モデルを悪意ある処理へ組み込むと、その運用者が使い方や接続を決めます。サービス会社が不正利用を見つけて停止する経路を外れたまま、調査や作業の補助を使い続けられる点が、守る側には厄介になります。これは攻撃の成功を保証する能力ではなく、犯罪利用を抑える制御が一つ届きにくくなるという構造です。
実悪用・AI一般の効率化・将来予測を分ける
AIとサイバー攻撃のニュースを読むときは、「AIを使った」「公開モデルを使った」「ローカルで動かした」「攻撃が成功した」を一つの事実にまとめないことが大切です。
| 資料 | 確認・評価していること | ローカルLLMとの関係 |
|---|---|---|
| GTIG・2026年9月 | 侵害したクラウド環境へのLLM基盤展開を観測 | 公開モデルの自主管理利用が明記された事例 |
| NICT・2026年10月 | 公開アプリから接続先を狙う攻撃を国内漏洩の一因に特定 | AIによる効率化を警告。個々の漏洩のAI・ローカル使用を実証した資料ではない |
| NCSC・2027年までの評価 | AIによる既存攻撃の効率化や脅威の増大を予測 | 公開モデルへのアクセスも評価する将来分析 |
出典:GTIG、NICT、NCSC。表の異なる資料を足して、ローカルLLMによる被害件数や増加率を算出することはできません。
NICTの例では、利用者に配布されるアプリだけでなく、その背後でデータを提供するサーバーが守る対象になります。マーケティング部門がアプリの見た目や利用者数だけを管理し、接続先の更新責任を把握していなければ、事業の接点と保護の責任が分断されます。これはAIの有無にかかわらず存在する問題ですが、解析が効率化するなら、見つけられずに済んでいた弱点へ期待する運営は難しくなります。
なお、GTIGの同じ報告には別のAI支援攻撃もあります。しかし、別事件の速さを自主管理モデルの事例へ結び付けて「ローカルLLMだからこの速度で成功した」とすることはできません。経営判断に使う際には、実行環境と結果が同じ事例で確認されているかを見ます。
なぜ守る側の対応が難しくなる?問題は既知の弱点に届く速さと広さ
AIを使っていない会社も、攻撃側の効率化の影響を受ける
2026年10月30日の防衛研究所の論考は、一連の事案を考えるうえで、未知の高度な攻撃だけでなく、既知の脆弱性や管理不備を狙う攻撃の規模とテンポに注意を向けています。脆弱性は、ソフトウェアなどにある、攻撃へ悪用され得る弱点です。これは筆者による分析です。防衛研究所の論考
この観点から考えると、自社がAIを導入していないことは、攻撃対象から外れる理由になりません。公開Webサイト、ログイン画面、アプリの接続先、委託先の管理画面などは、従来から外部とつながっています。攻撃する側の作業が効率化すれば、その接点を調べる試みが広がる可能性があります。
AIがあるだけで侵入が成立するわけではなく、利用可能な弱点や権限が必要です。だからこそ、更新、認証、公開範囲の管理といった基本対策の価値は残ります。変わるのは、「弱点が分かったが担当者が忙しいので後で」という時間の使い方です。
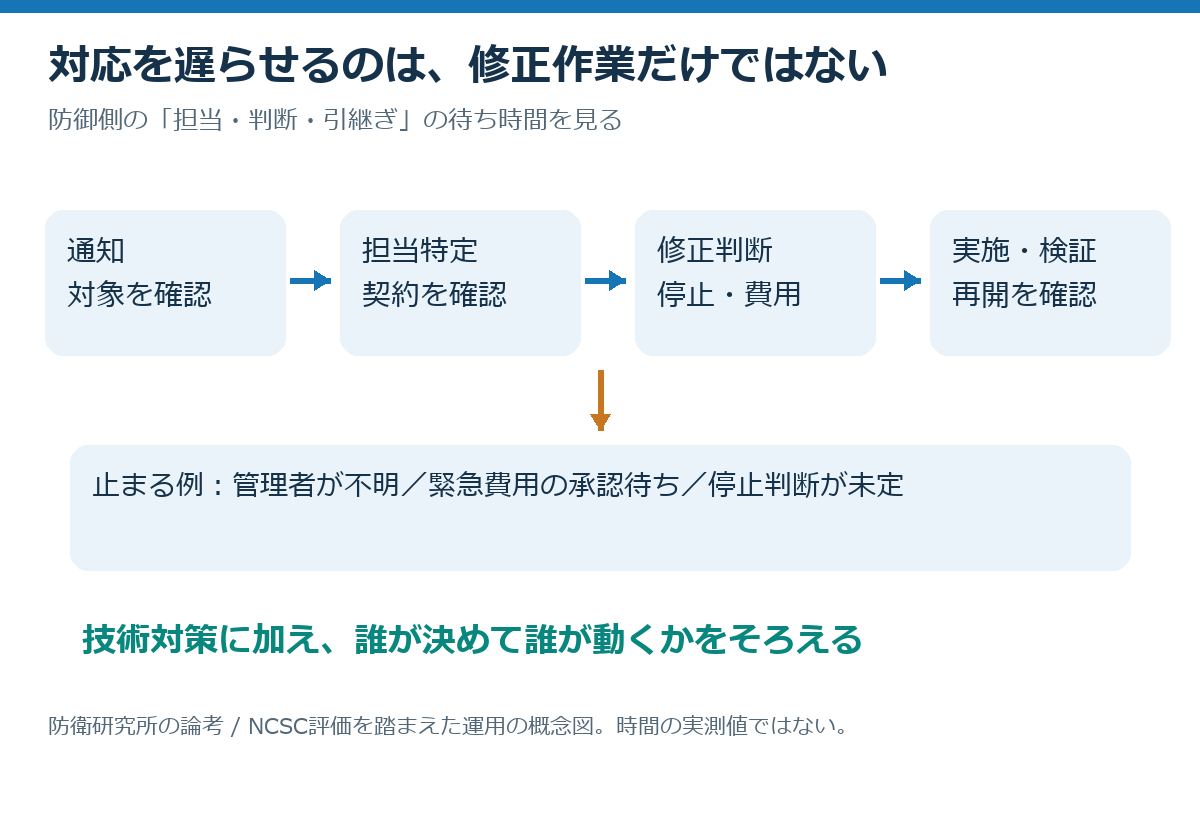
図は上記論考とNCSCの評価を踏まえた運用上の整理で、実測の対応時間や攻撃成功率を示すものではありません。
ボトルネックは、技術者が修正する時間だけではない
たとえば販促サイトに修正が必要になった場面を考えます。制作会社はページを作ったものの、サーバーは別会社、利用契約は以前の担当者名義、事業部はキャンペーン期間中の停止を避けたい。この状態では、修正方法が分かっていても、誰が費用を決め、誰が作業し、誰が動作を確認するかで止まります。
これは状況を理解するための仮例です。重要なのは、攻撃者のAI利用を一件ずつ見分けるより先に、自社の対応経路を短くできるという点です。AIによる攻撃の高速化に対し、防御側もAI製品を買えば同じだけ速くなるとは限りません。権限や契約、担当範囲が不明なままでは、通知を自動化しても作業が進まないからです。
対応の優先順位も「古いソフトを全部同時に直す」だけでは決められません。外部からアクセスできるか、顧客情報や管理権限につながるか、修正まで接続を限定できるかという条件を、技術担当と事業担当が共有します。どの施策を止めるとどの売上機会に影響するかは事業側、技術的に何が危険かはIT側が情報を持っています。
その両方がそろえば、重要な接点の修正を先に実行し、必要な停止を判断できます。「セキュリティはITに任せている」という分担と、事業側が判断材料を渡さないことは別です。
技術的な深刻度と自社の事業影響をどう組み合わせるかは、脆弱性対応の優先順位の決め方も参考になります。
自社でローカルLLMを導入するときのセキュリティ対策
外部へ送らないことと、社内で見せてよいことを分ける
ローカルLLMは、情報の外部送信を抑える選択肢です。しかし社内の誰が何を見られるかは、別に設計する必要があります。
たとえば人事情報と一般の社内規程を同じ検索対象へ入れ、利用者全員へ同じ権限で回答する構成にすれば、処理が社内で完結していても不適切な開示が起こり得ます。社内文書をAIに読ませる際には、文書の保存場所だけでなく、質問した人にその内容を返してよいかが問われます。
NTTの解説も、社内情報を参照する仕組みや追加学習の利用に伴う機微情報の出力を扱い、用途に応じた対策と多層防御を説明しています。NTT技術ジャーナル
導入時に決めるのは、モデルだけでなく運用の責任
| 確認対象 | 具体的な確認 | 判断につながること |
|---|---|---|
| データの流れ | モデル・ログ・外部連携の保存先と通信先 | 機密データを扱える範囲 |
| 利用者の権限 | 誰が、どの文書や機能へアクセスできるか | 部署を越えた情報開示の防止 |
| 外部からの接続 | 社外へ公開している機能と認証 | 社内専用という前提の確認 |
| モデルとソフトの取得 | 配布元、版、更新を承認する担当 | 不明な構成や放置の防止 |
| 実行できる操作 | 閲覧・作成・送信・削除の範囲 | 誤出力が実害になる範囲の限定 |
| 障害・不正利用 | 記録、連絡先、停止と復旧の担当 | 検知後に動ける体制 |
表は業務設計の確認事項です。具体的な設定値は、機密性、接続先、利用者数などに応じて決めます。
最初の検証では、入力する情報を限定し、生成物を人が確認する範囲から始める方法があります。社内展開へ進むときは、同じ設定を配布するだけでなく、利用者の追加・退職、更新、事故時の停止まで運用を引き継ぎます。
「導入できた」と「安全に使い続けられる」の間にあるのは、この継続的な仕事です。便利なツールを否定する必要はありませんが、管理する人と時間を含めて採算を考えなければ、安く見えた導入費の外側に負担が残ります。
マーケティング部門は、サイト・フォーム・顧客データの何を確認するか
成果につながる接点と、守るべき接点は重なる
マーケティングの成果は、広告やコンテンツだけでは完結しません。サイトから問い合わせを受け、顧客情報を営業へ渡し、購入や継続利用につなげるシステムに支えられています。障害や情報漏洩が起きれば、広告を増やしても獲得できない期間や、説明・連絡・再発防止の仕事が発生します。
ローカルLLMの悪用を知る意義は、「新しい怖いAIがある」と覚えることではありません。攻撃者がどの商用AIを使っているかに関係なく、弱い接点へ到達される前提で、事業を続ける条件を整えることです。
| マーケティング上の接点 | IT・委託先へ確認すること | 事業側が決めること |
|---|---|---|
| LP・キャンペーンサイト | 稼働中のサイト一覧、更新担当、終了後の閉鎖 | 終了案件を残す必要と閉鎖日 |
| フォーム・会員登録 | 接続先、管理権限、異常時の検知と連絡 | 停止中の代替窓口と顧客案内 |
| 顧客データの連携 | 外部サービスや代理店へのアクセス範囲 | 共有する項目と利用終了時の扱い |
| アプリ・会員向け機能 | サーバー側も含む保守範囲 | 修正時の告知と重要機能の優先度 |
| AIによる制作・自動処理 | 利用環境、送信データ、実行権限 | 人が確認する工程と承認者 |
この表は、特定の事件の被害企業を再現したものではなく、確認した脅威の構造を業務判断へ落とした整理です。
「委託しているから大丈夫」から、実行できる分担へ
たとえば「更新は制作会社が担当」と決めても、その契約にサーバーの更新が含まれるのか、緊急作業は別料金なのか、夜間に停止を判断できる人は誰かによって、対応できる範囲は変わります。毎回の作業内容をマーケティング担当者が技術的に判断する必要はありません。代わりに、契約・連絡・意思決定がつながっているかを確認します。
相手が扱う情報とシステムへの接続を整理する方法は、委託先のセキュリティ管理で解説しています。
費用対効果を見る際も、対策費を広告費から単純に差し引くだけでは不十分です。重要な獲得経路が止まると、進行中の施策、顧客対応、営業への情報連携に影響します。どの接点を優先して守るかは、保有データの重要性と事業への影響を合わせて決める判断です。
そのため、AIの脅威を理由にあらゆる対策へ一律に投資するより、まず管理対象と責任の空白を明らかにします。既存サイトを整理し、修正・停止・復旧の判断を共有できれば、新しい監視や自動化を導入したときにも、その通知を実際の対応につなげやすくなります。
まとめ:ローカルLLMの自由度を知ると、防御の責任が見えてくる
ローカルLLMは、モデルを自分の環境で動かし、処理場所や使い方を選べる仕組みです。OllamaやLM Studioはそのための道具、Llama・Qwen・Gemmaなどは動かすモデルの系列です。機密保持、オフライン利用、独自の業務への組み込みという便益があります。
同時に、提供元のサービスを通らずに動くモデルまで、AIサービス会社の監視やアカウント停止で一括管理することはできません。公開モデルを自主管理する悪用も観測されており、商用サービスの制限だけに犯罪利用の防止を任せることには限界があります。
守る側に必要なのは、AIによって基本対策が無意味になったと考えることではなく、既知の弱点へ広く速く到達される可能性に備えることです。更新を止める担当不明、放置された外部接点、過大な権限、緊急時に決まらない判断を減らしていく。自社がAIを使うかどうかにかかわらず、この運用の質が事業を守る条件になります。
参考資料
- GTIG:From Prompting to Autonomy(2026年9月8日)
- 国際AI安全性報告2026
- 防衛研究所:NIDSコメンタリー第460号(2026年10月30日)
- NICT:A2B攻撃に関する発表(2026年10月13日)
- NCSC:AIが2027年までのサイバー脅威へ与える影響
- Ollama公式FAQ/利用案内
- LM Studio公式利用案内/オフライン利用
- OSI:Open Source AI Definition
- Llama公式/Qwen公式/Gemma公式
- NTT技術ジャーナル:安全なAI利用に向けたセキュリティ視点の取り組み
- AWS:Guardrailsの仕組み
制度・機能・公開資料の確認日:2026年10月31日。
本記事の文章・表・図解・グラフは、Skill Business Architecture Labが独自に編集・作成しています。引用・紹介する場合は、引用箇所が分かる形で、記事名・サイト名・記事URLをご記載ください。
コメント